Proyecto personal11 min de lectura
Hypeoslav - Holding de Medios con IA
Tecnologías
Enlaces
Contenido
- Desafío
- Descubrimiento
- Análisis de la competencia
- Opciones consideradas
- Decisión
- Implementación
- Resultado
- Landing y marca
- Identidad de los canales
- El pipeline en Blender
- Subtítulos animados
- Intros multilingües y portadas virales
- Archivos de guion por idioma
- Generación de avatares
- Cliente de escritorio para el visual
- Monitorización de tendencias
- Ampliación de la cuota de la API de YouTube
Servicios
- →Arquitectura y desarrollo de la canalización de IA (Python)
- →Interfaz de Bot de Telegram para control de la canalización
- →Integración multi-servicio de IA (imagen, texto, audio)
- →Ensamblaje de publicaciones y automatización de publicación multiplataforma
- →Configuración de monetización de YouTube e integración de AdSense
Entregables
- ✓Canalización descentralizada de generación de contenido activada desde Telegram
- ✓Integraciones: Midjourney, DALL·E, Recraft, ChatGPT, Gemini, ElevenLabs
- ✓Tiempo de producción: de 2, 3 horas y luego menos de 5 minutos por publicación
- ✓Varios canales monetizados funcionando en paralelo con un solo operador
Desafío
Cofundé Hypeoslav como un holding de medios nativo en IA, varios canales de contenido que producen imagen, texto y audio a escala. La economía solo funciona si el costo de producción por publicación es cercano a cero. Los flujos manuales en Midjourney, ChatGPT, ElevenLabs y las herramientas de publicación tomaban entre 2 y 3 horas por publicación. Eso no era un negocio de medios; era un estudio de producción manual.
Descubrimiento
Desglosar el flujo de producción de contenido reveló que cada paso era mecánico: escribir el prompt y luego generar la imagen, escribir el subtítulo, generar la locución, ensamblar la publicación and then publicar en el canal. Ninguno de estos pasos requería juicio creativo humano una vez definido el brief. El cuello de botella no era la creatividad, era la orquestación.
Análisis de la competencia
Antes de construir nuestro propio pipeline, estudiamos las herramientas de la competencia y pasamos proyectos de prueba por ellas. Queríamos quedarnos con lo que ya funcionaba, corregir lo que no nos gustaba y encontrar los puntos donde nuestro pipeline necesitaba su propia solución. Las capturas muestran una de esas herramientas: una aplicación de escritorio que divide el guion en escenas y asigna a cada escena un prompt de imagen y su narración. El editor puede mejorar el prompt, regenerar la imagen o aceptar la escena y pasar a la siguiente. El nombre del producto está oculto.
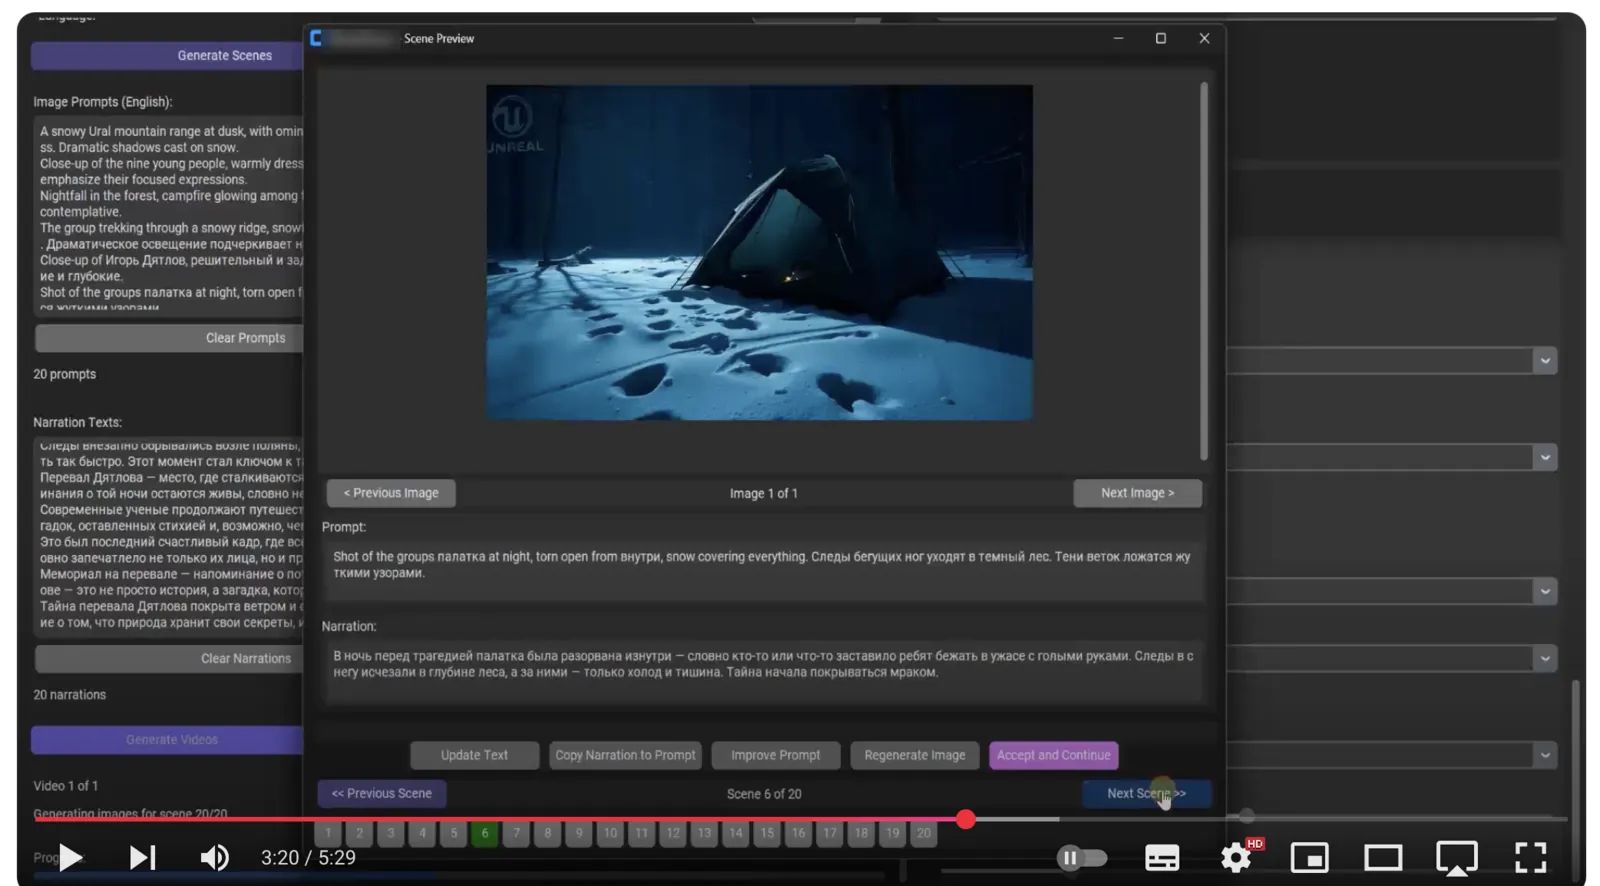
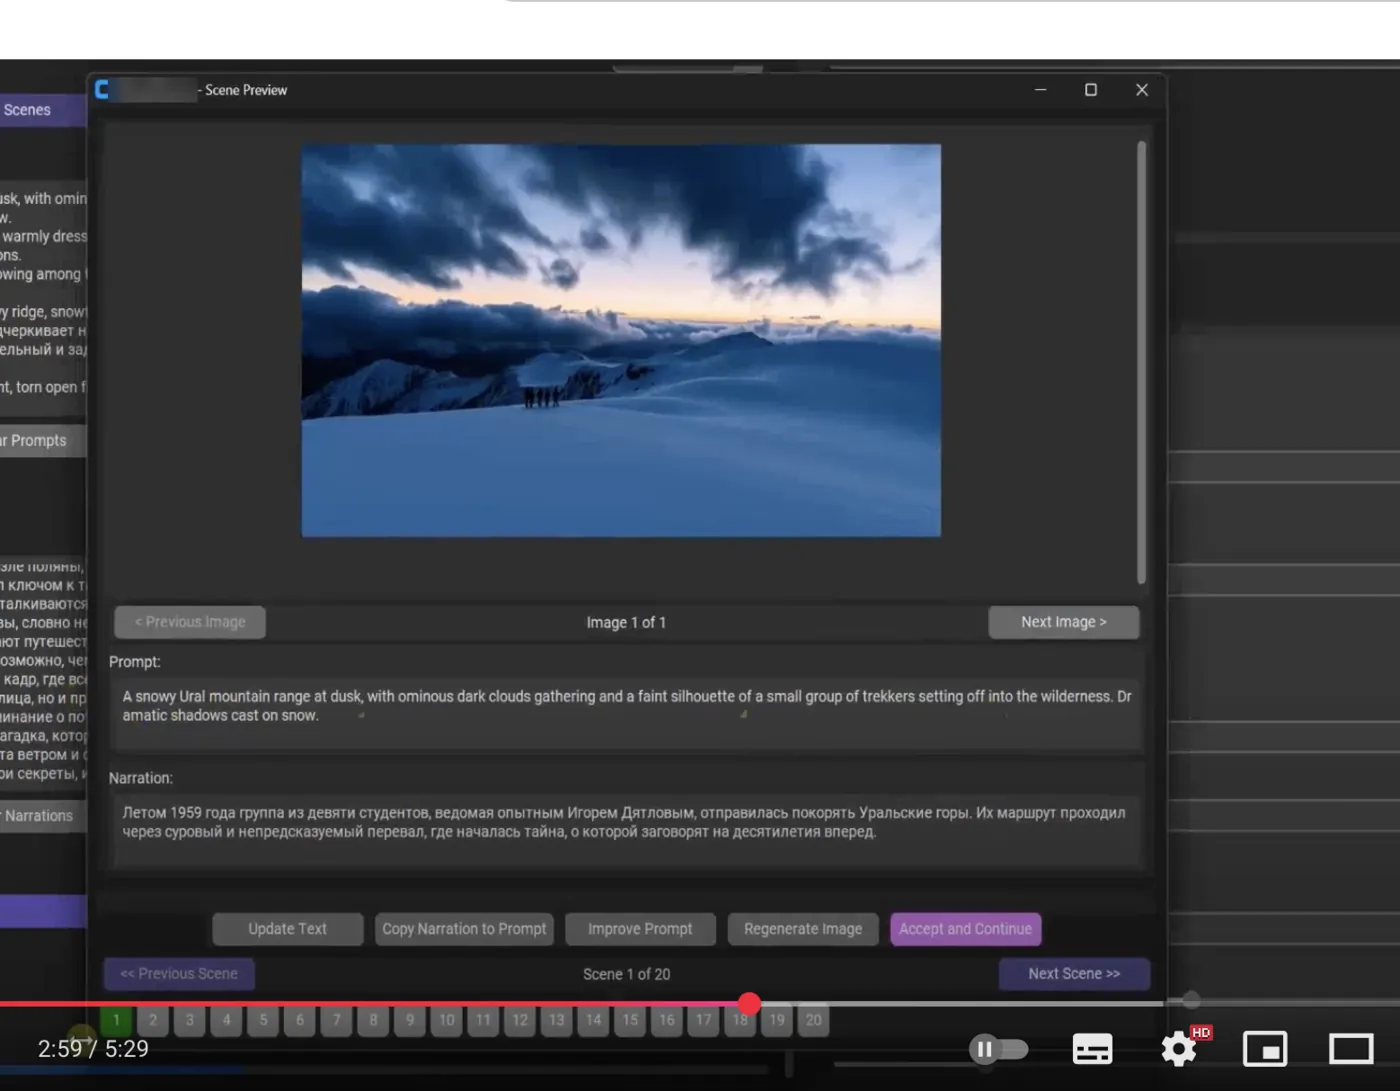
Editor de escenas de un competidor, nombre del producto oculto
Opciones consideradas
- Herramientas de automatización sin código (Zapier, Make), evaluadas. No podían manejar las llamadas a API de IA en varios pasos, el manejo de errores ni el enrutamiento condicional entre servicios de generación.
- Panel web personalizado: descartado. Los editores no querían otra pestaña que gestionar; la interfaz debía estar donde ya trabajaban.
- Bot de Telegram como interfaz de control + canalización backend en Python: elegido. Los editores ya usaban Telegram; los comandos del bot daban acceso instantáneo a la canalización desde cualquier dispositivo.
Decisión
Una capa de orquestación en Python se conecta a todas las API de IA. La API del Bot de Telegram es la interfaz: un editor envía un brief de contenido, la canalización se distribuye en paralelo a los servicios de generación adecuados, ensambla el resultado y o bien publica automáticamente o presenta una vista previa para aprobación. Cada tipo de canal (con predominio de imagen, de texto o de audio) tiene su propia variante de canalización.
Implementación
Se integraron Midjourney (vía automatización de la API de Discord), DALL·E y Recraft para generación de imágenes, ChatGPT y Gemini para subtítulos y guiones, y ElevenLabs para locución. Cada servicio tiene su propio manejador asíncrono con lógica de reintentos y enrutamiento de respaldo, si Midjourney va lento, la canalización cambia automáticamente a Recraft.
El ensamblaje de publicaciones combina los recursos generados en formatos nativos de cada plataforma para canales de Telegram, YouTube Shorts e Instagram. La programación se gestiona mediante una cola que distribuye las publicaciones en las ventanas de publicación óptimas. Se configuró la monetización con YouTube AdSense en todos los canales de video.
Resultado
El tiempo de producción de contenido bajó de 2, 3 horas a menos de 5 minutos por publicación. Varios canales funcionan en paralelo con un solo operador. La infraestructura gestiona la canalización creativa de extremo a extremo. El rol humano es la definición del brief y el control de calidad, no la ejecución de la producción.
Landing y marca
Hypeoslav tuvo una landing de producto y una identidad propia. En su centro está una chica con kokóshnik y botones de YouTube en las mejillas; abajo, varias versiones del logotipo con el nombre en cirílico y en latino sobre distintos fondos. A través del sitio se podía contactar con nosotros, escribir al equipo por correo, ver quién lo formaba y ejemplos de nuestros vídeos. Más adelante nos asociamos con otros productores de vídeos virales: hablábamos con ellos de nichos y trabajábamos juntos.
Variantes del logotipo y logotipo tipográfico
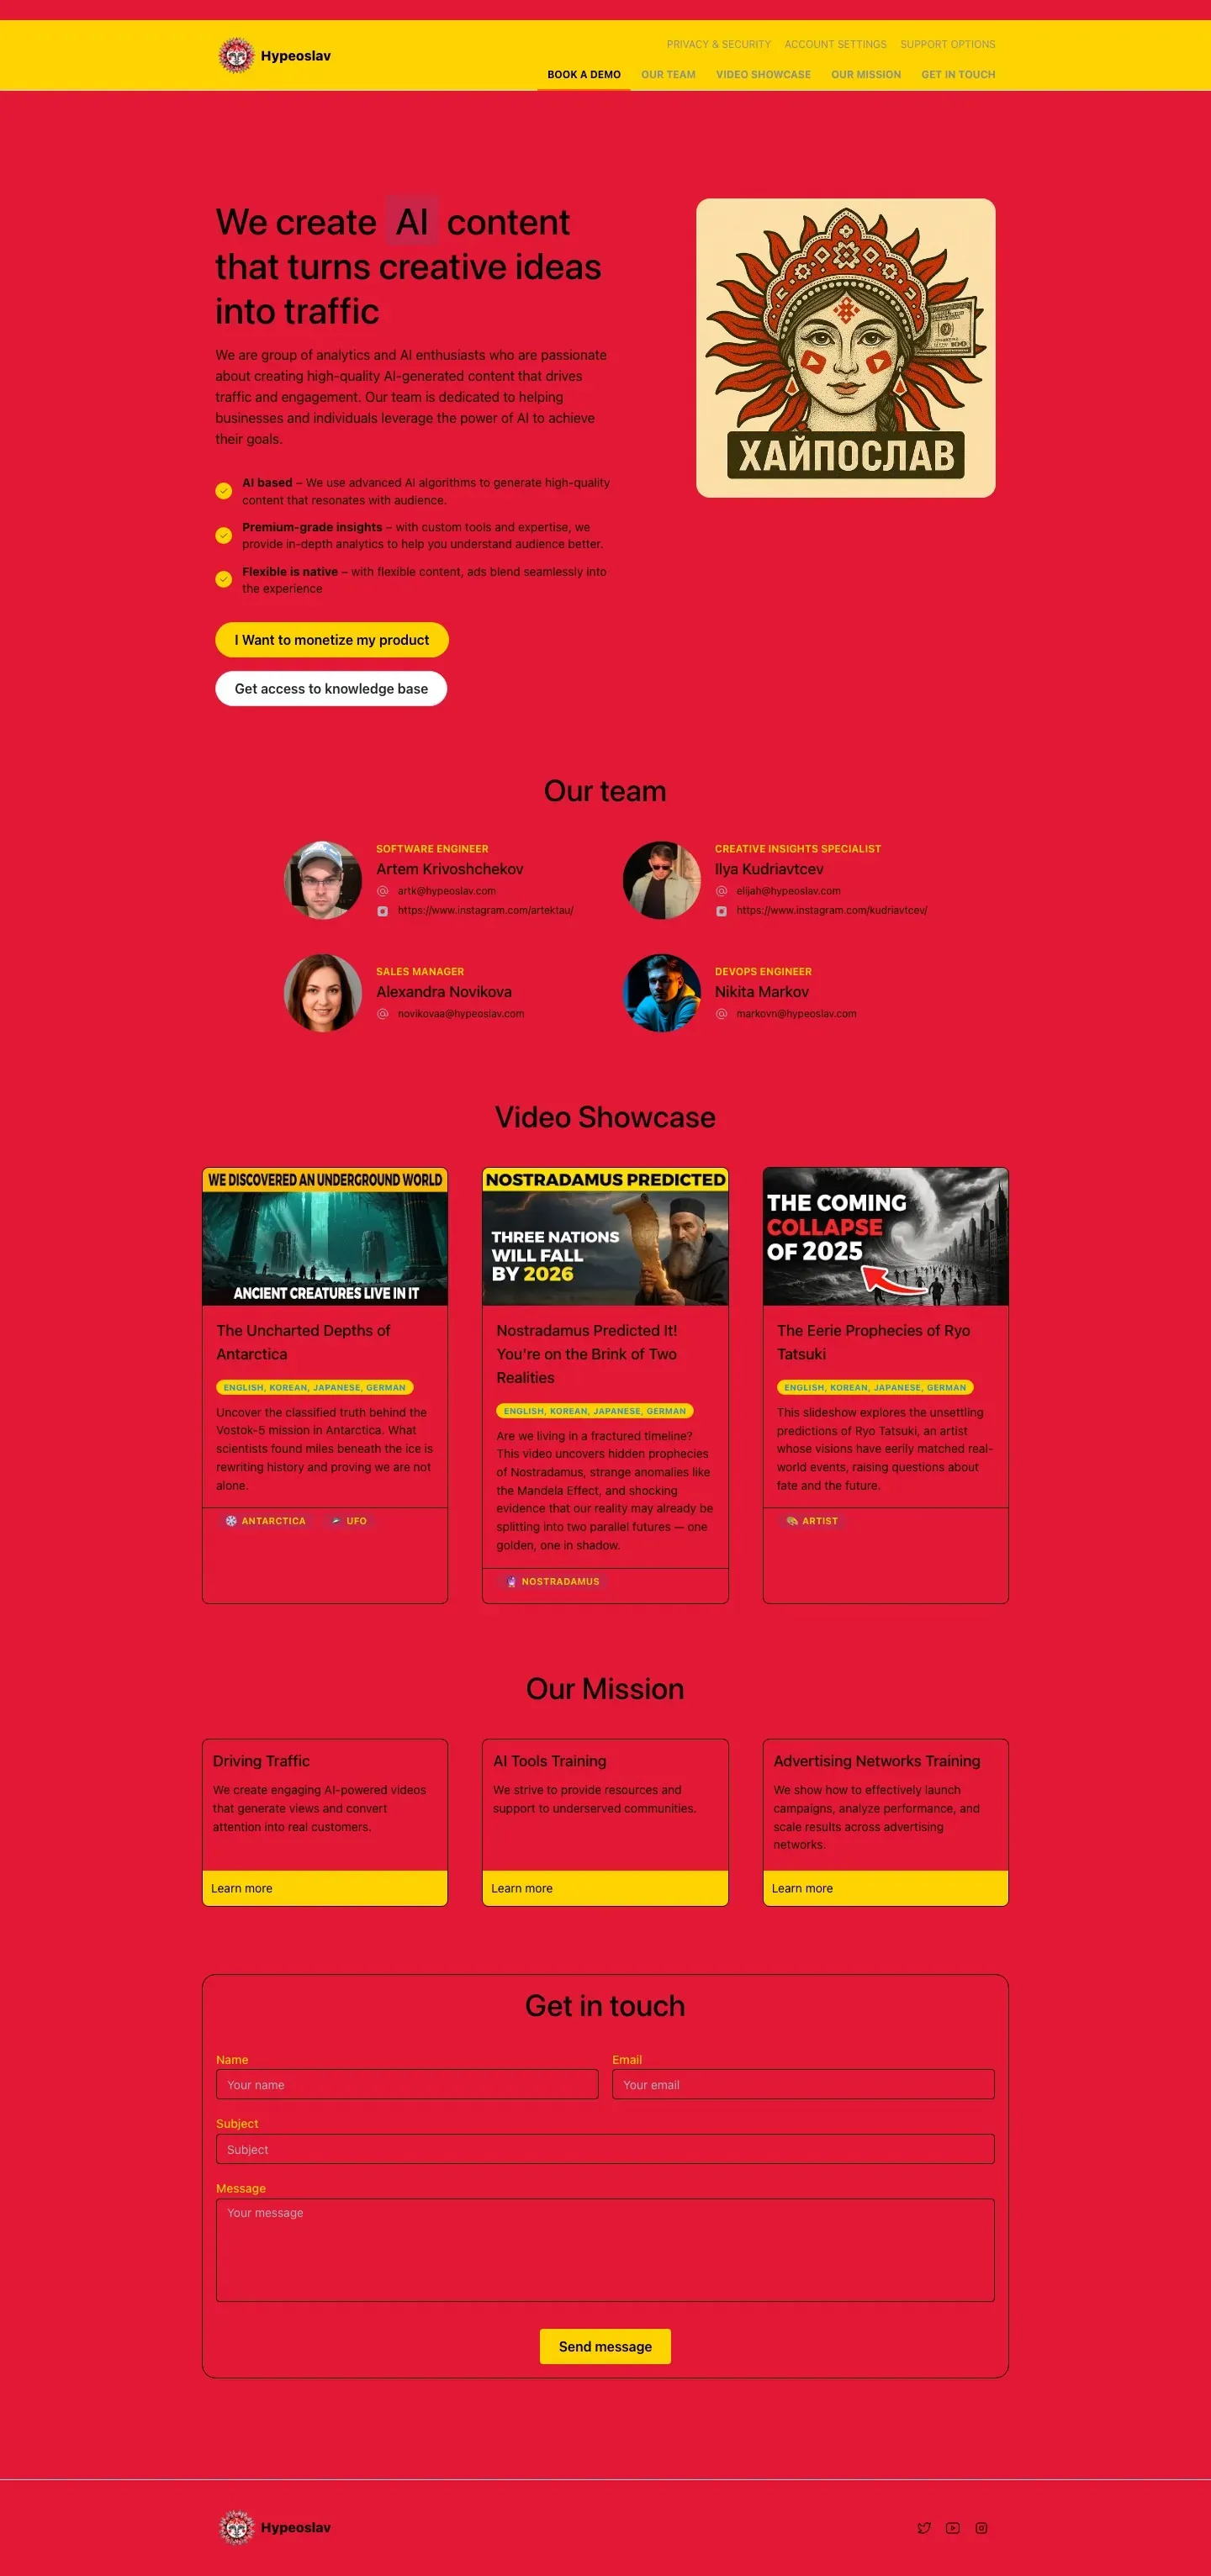
Static snapshot — scrollable Safari preview
Identidad de los canales
Cada canal temático recibió su propia identidad: un avatar y un banner de fondo, diseñados según lo que funciona en títulos y miniaturas virales. Una misma temática se publicaba en varios idiomas a la vez, así que la misma marca aparece con rótulos en coreano, inglés y alemán. Los nombres se adaptaron en lugar de traducirse palabra por palabra: «The Mental Key» en inglés pasó a ser «Abrir la puerta de la corteza» en coreano.
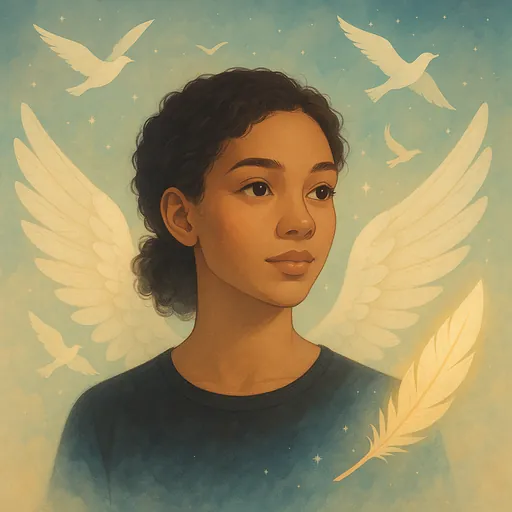
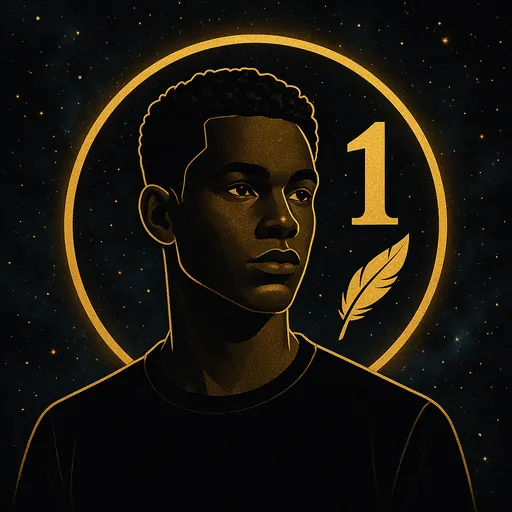
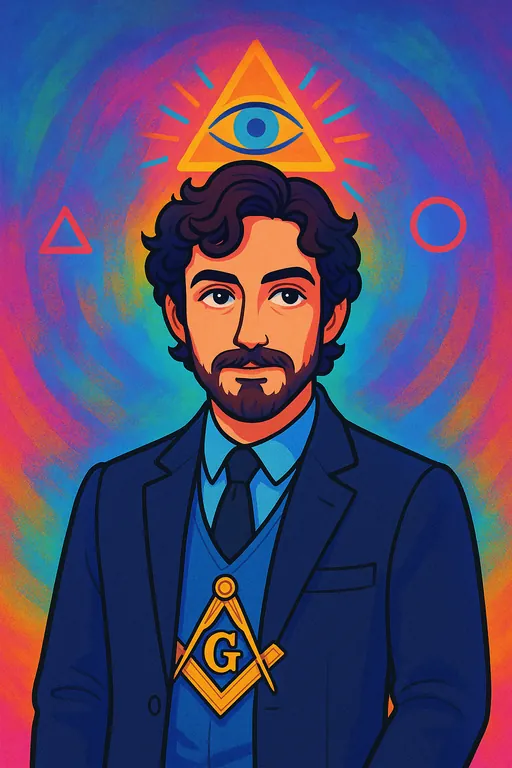
Avatares de los canales
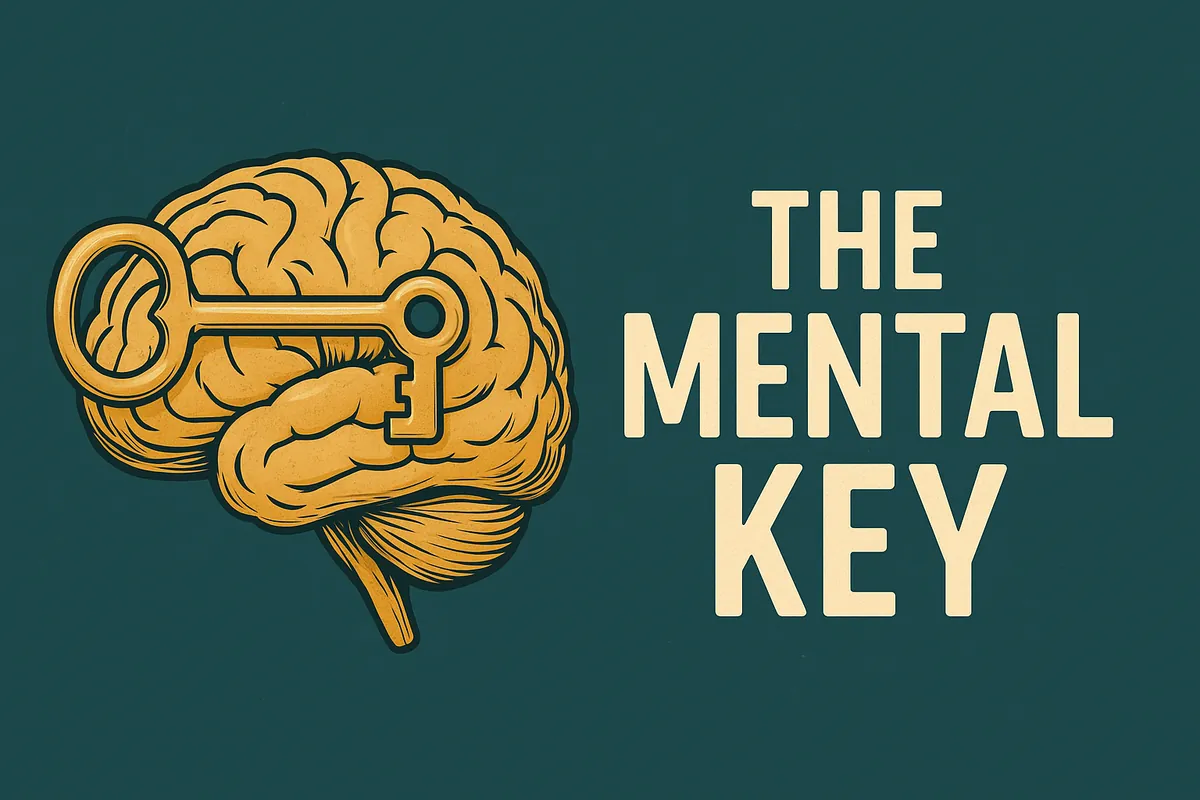
Banners de los canales
El pipeline en Blender
Una etapa intermedia del pipeline, capturada en Blender. La escena se monta automáticamente: las imágenes se colocan y se alinean, el avatar se superpone encima y un efecto de humo recorre el plano (una versión temprana). Todas las imágenes y escenas del clip salieron de la fase con LLM. Los subtítulos se añadieron aparte, ya fuera de Blender.
Blender se controla por completo desde Python. El script arma la línea de tiempo, reparte clips y superposiciones entre los canales, compone el plano y aplica efectos, por ejemplo un Ken Burns: un zoom suave con un punto de foco aleatorio en cada imagen fija.
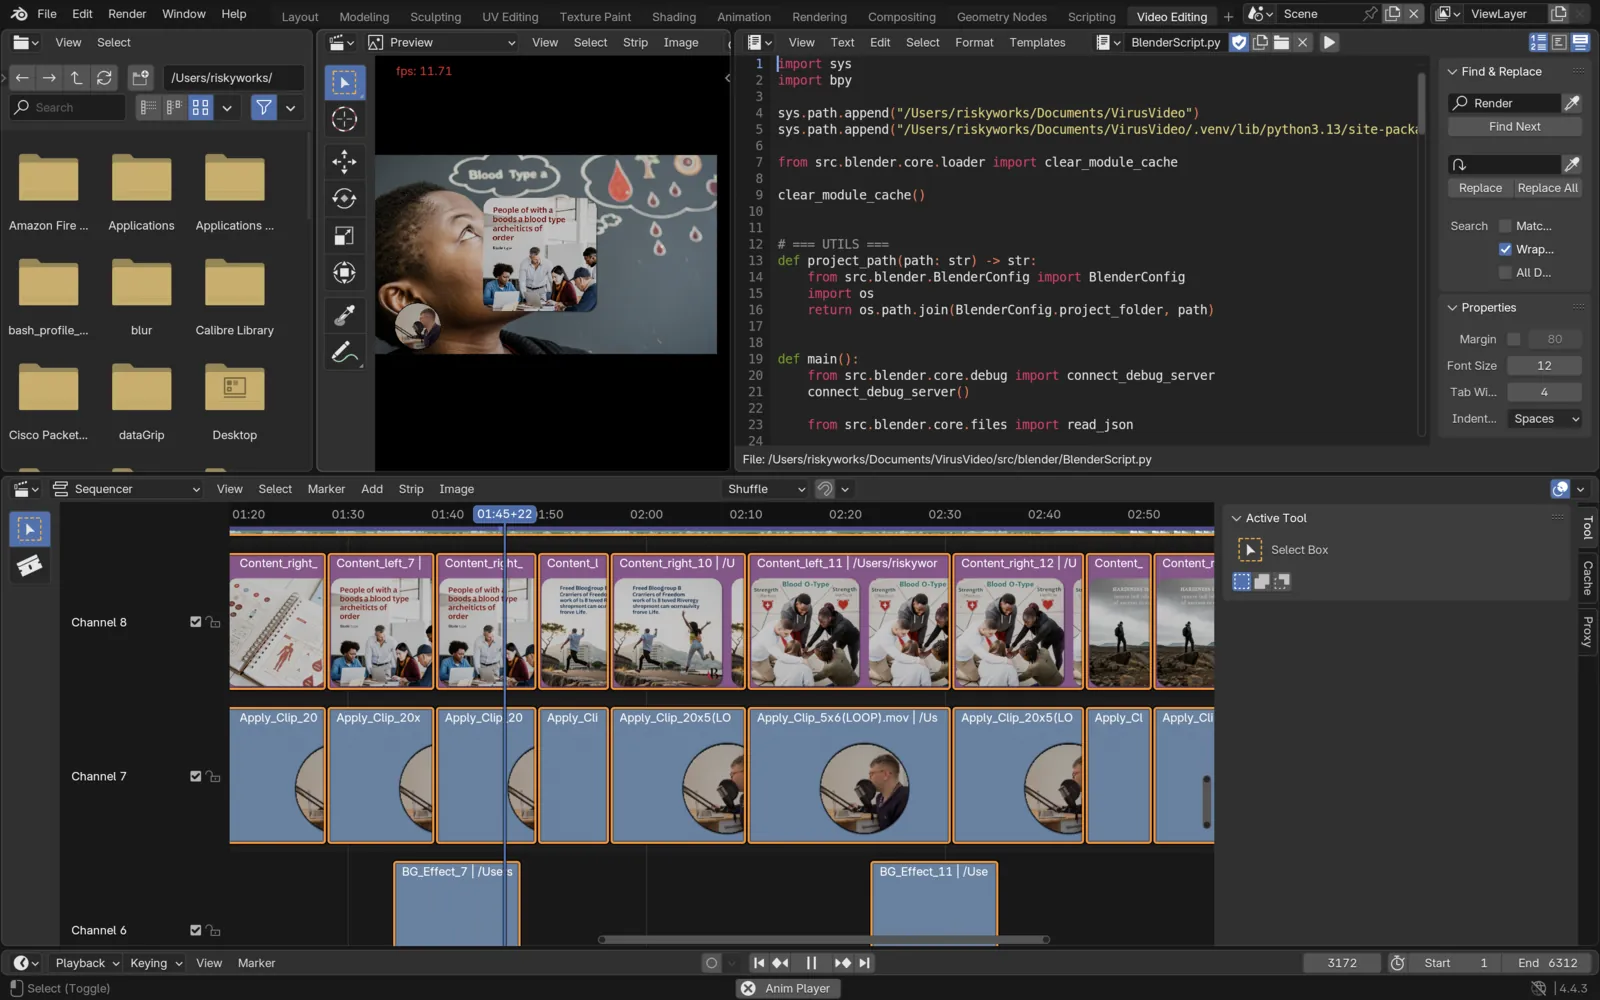
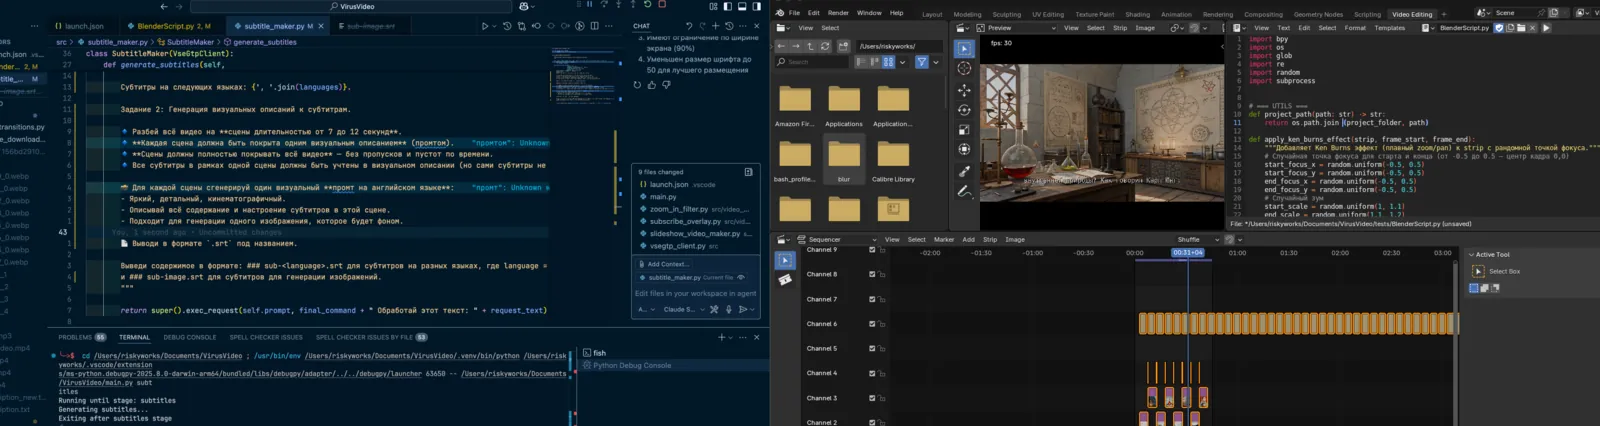
La línea de tiempo, la composición y los efectos los monta el código Python
Subtítulos animados
Los subtítulos son animados, al estilo karaoke, con la palabra actual resaltada a medida que se pronuncia. Blender no manejaba bien los subtítulos, así que la fusión se hizo con ffmpeg: Blender entregaba un render limpio y la pista de subtítulos se incrustaba en una pasada aparte. Los estilos se mejoraron más adelante. Se añadió una sombra y se completó la fuente con los glifos que le faltaban para que soportara otros idiomas, coreano y japonés incluidos. La versión original fallaba con esos.
Los subtítulos se generan automáticamente en varios estilos, entre ellos el karaoke, donde cada palabra se ilumina en el momento en que se pronuncia.
Estilo de subtítulos karaoke
Intros multilingües y portadas virales
Intros generadas en varios idiomas, junto con las portadas con las que arrancan los vídeos. La voz fue lo que más búsqueda costó: se probó una tanda de modelos locales de síntesis, entre ellos los basados en Kokoro y los lanzamientos de Facebook, antes de elegir ElevenLabs como herramienta principal de locución.
Las portadas tienen su propio juego de prompts. En lugar de describir una imagen, los prompts codifican lo que ya funcionó: se desmontaron miniaturas de referencia que se habían vuelto virales y sus patrones se trasladaron a las generadas.
Archivos de guion por idioma
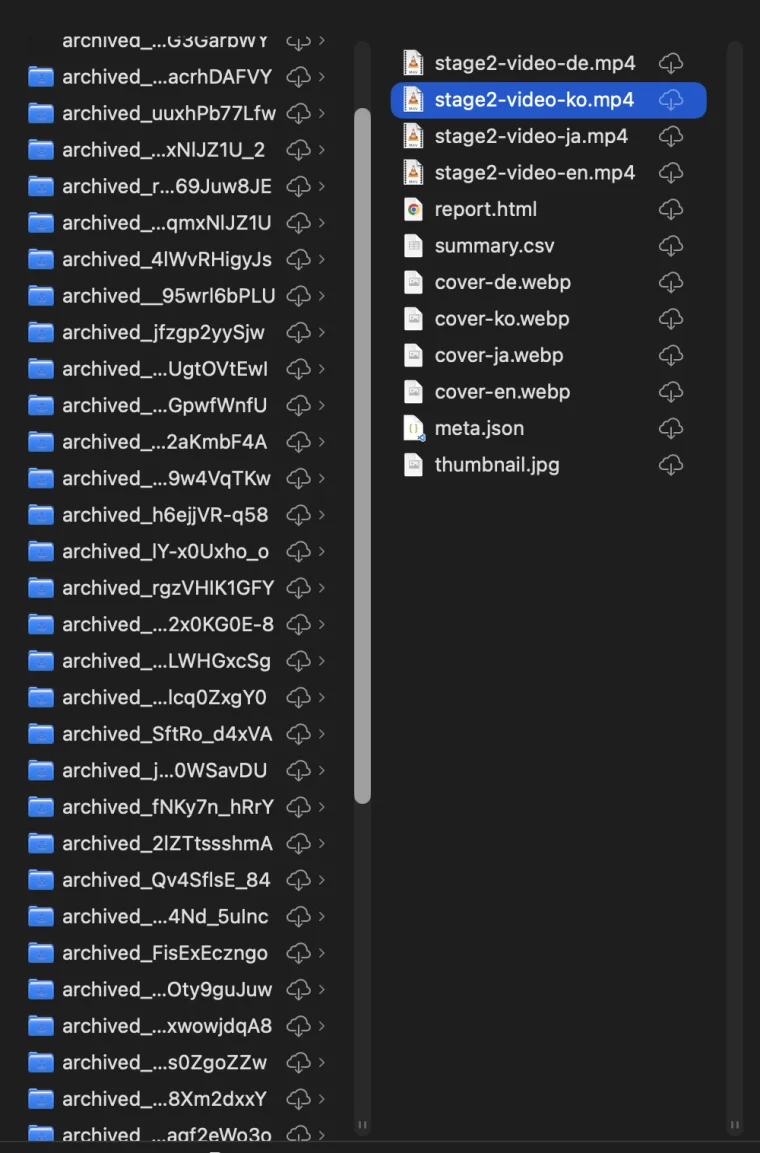
La estructura de archivos con la que trabaja la canalización: los guiones reescritos más sus metadatos, un juego por idioma. Lo que le dio esta forma es el requisito de que el vídeo salga con una duración aproximadamente igual sea cual sea el idioma final, así que los guiones se adaptan a un metraje en lugar de traducirse línea por línea. Una traducción literal se desvía: con el mismo número de palabras unos idiomas suenan bastante más largos que otros, y la sincronización con la imagen se rompe.
Generación de avatares
Los avatares se generan en ComfyUI con un conjunto de modelos, y la canalización saca el vídeo de ahí mediante una integración en lugar de llamar a un servicio de pago. Eso abarató mucho el proceso, la generación externa era la partida más cara, y además puso la calidad bajo control directo: el modelo, los ajustes y el número de pasos se afinan por canal en vez de aceptar lo que devuelva un endpoint ajeno.
Elegimos ComfyUI porque los resultados de otras interfaces no nos convencían, y montamos allí nuestro propio flujo de generación de avatares. Los avatares se mantuvieron a propósito: un presentador en pantalla aumenta la confianza del espectador y la retención del vídeo.
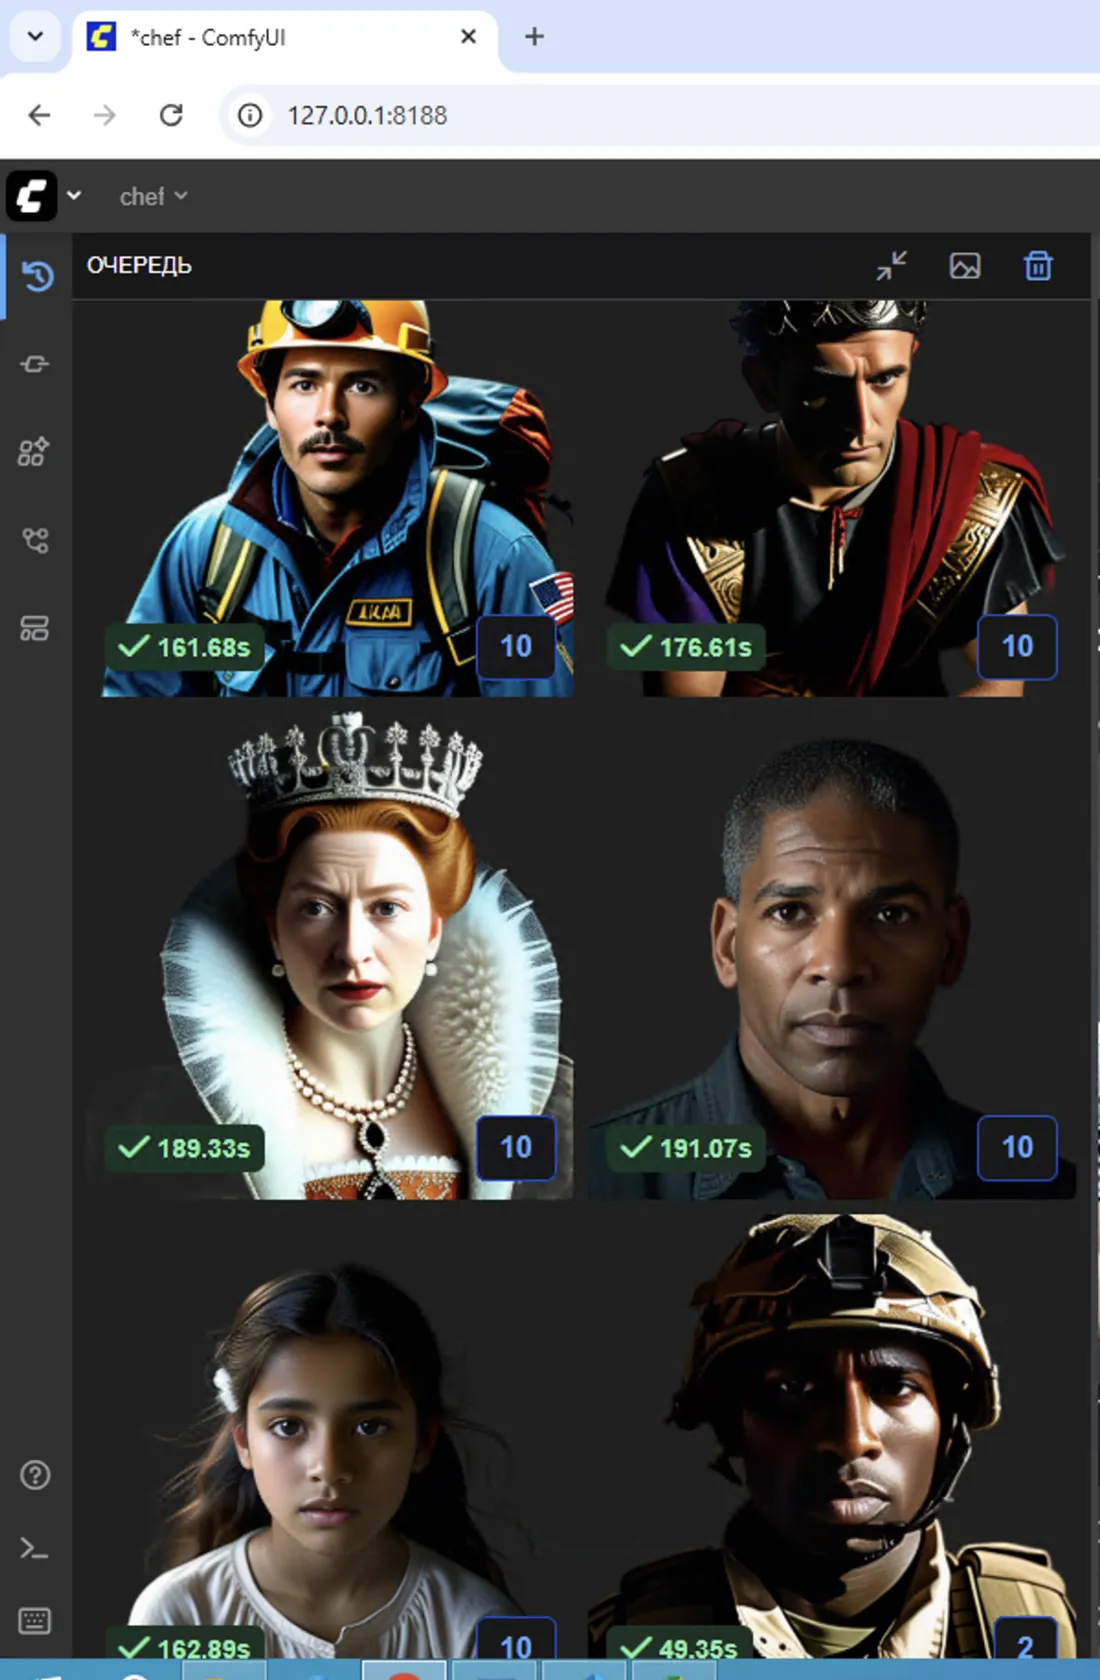
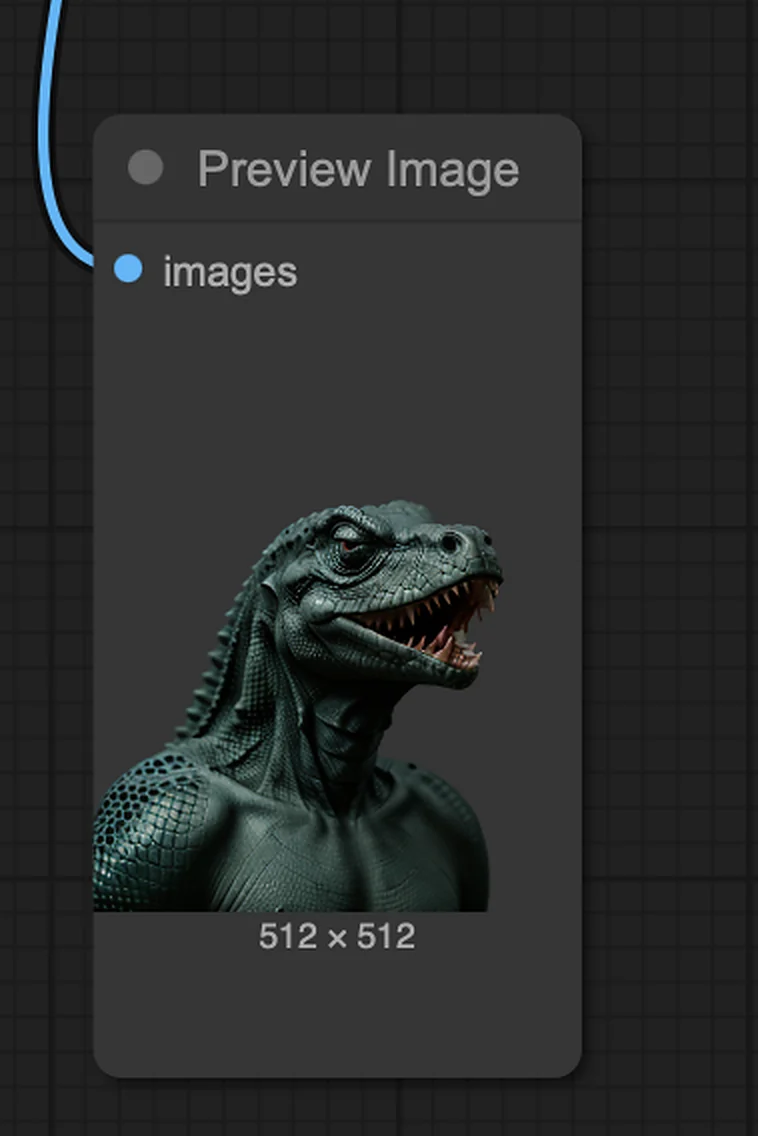
Avatares generados por nuestro flujo en ComfyUI
Bot de control en Telegram
Que la canalización funcionara 24/7 implicaba poder gobernarla desde el móvil, así que el mando es un bot de Telegram. El trabajo es multihilo: las tareas entran en una cola y los workers esclavos las van tomando según se liberan, en vez de que un trabajo bloquee toda la fila.
La generación de vídeo va por etapas, y las que necesitan ojo humano se detienen a esperarlo. El bot informa de que la etapa está lista y pasa a otro trabajo en lugar de quedarse parado. El operador abre el resultado desde Google Cloud, por eso la revisión se puede hacer desde el móvil, y responde aceptar o rehacer, con la opción de cambiar el prompt antes del reintento. El vídeo final se sube a Google Drive.
El bot también se ocupa del camino de fallo: una tarea que falla se notifica con su error en vez de morir en silencio dentro de la cola, y se puede reiniciar desde el propio chat.
El recorrido completo paso a paso, con los resultados intermedios aprobados etapa por etapa.
Cómo funciona el bot
El bot corre sobre un servicio web propio en nuestro servidor. Escucha los comandos, reparte las tareas entre los ejecutores y devuelve la respuesta al chat. Todos los archivos intermedios que requieren una decisión humana, aceptar o rehacer, se suben a Google Cloud, así que el pipeline se puede administrar en remoto, sobre la marcha. Para moderar imágenes en el PC se creó una aplicación de escritorio aparte, RenderOrc, descrita más abajo en «Cliente de escritorio para el visual».
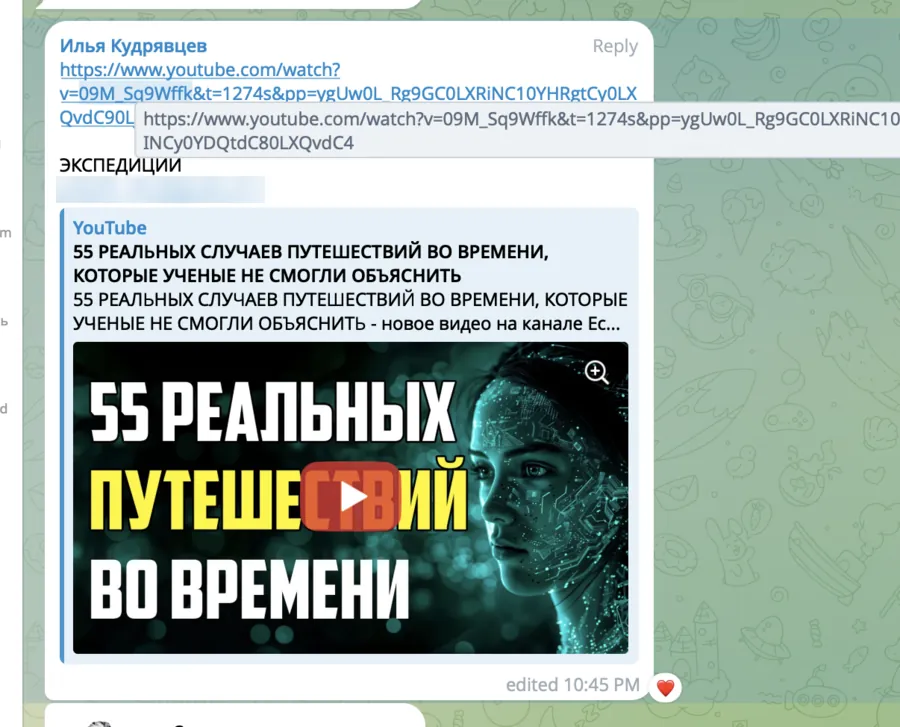
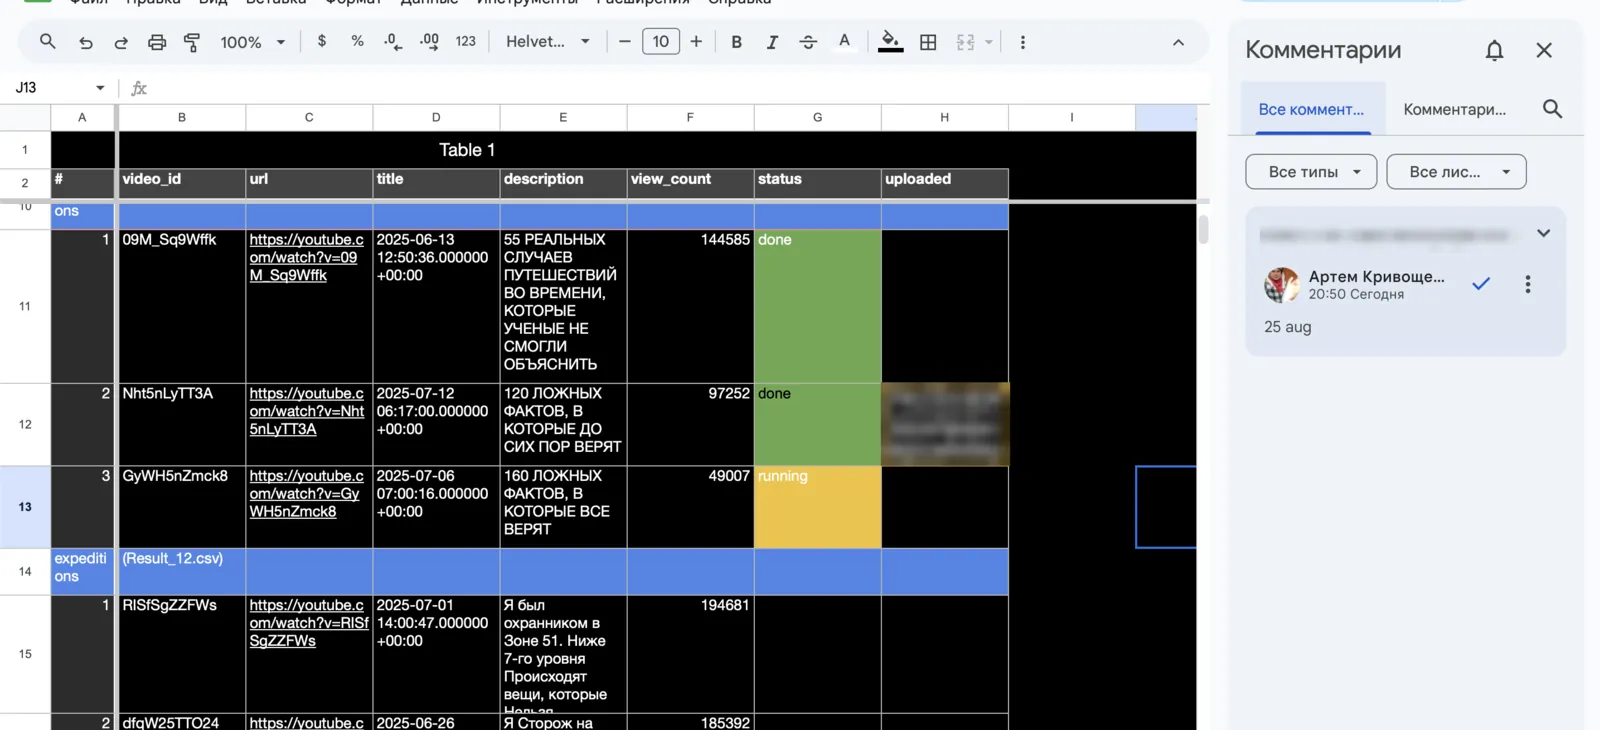
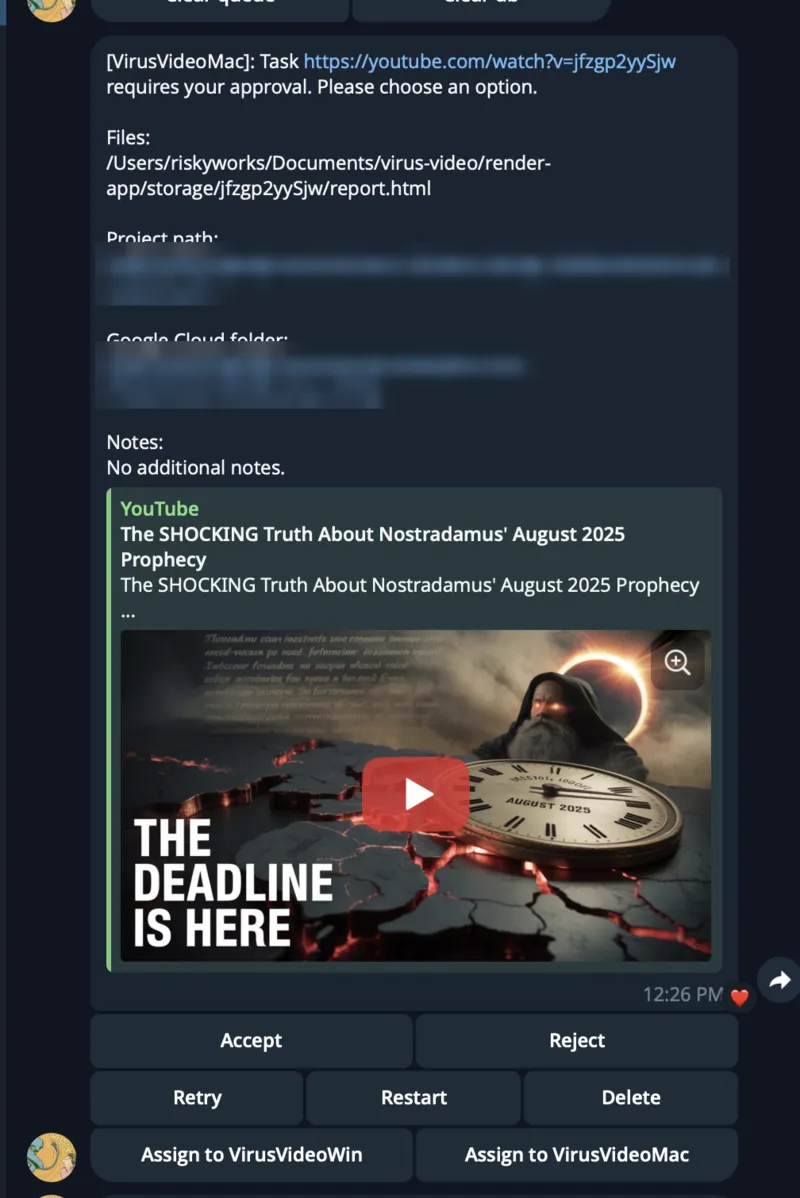
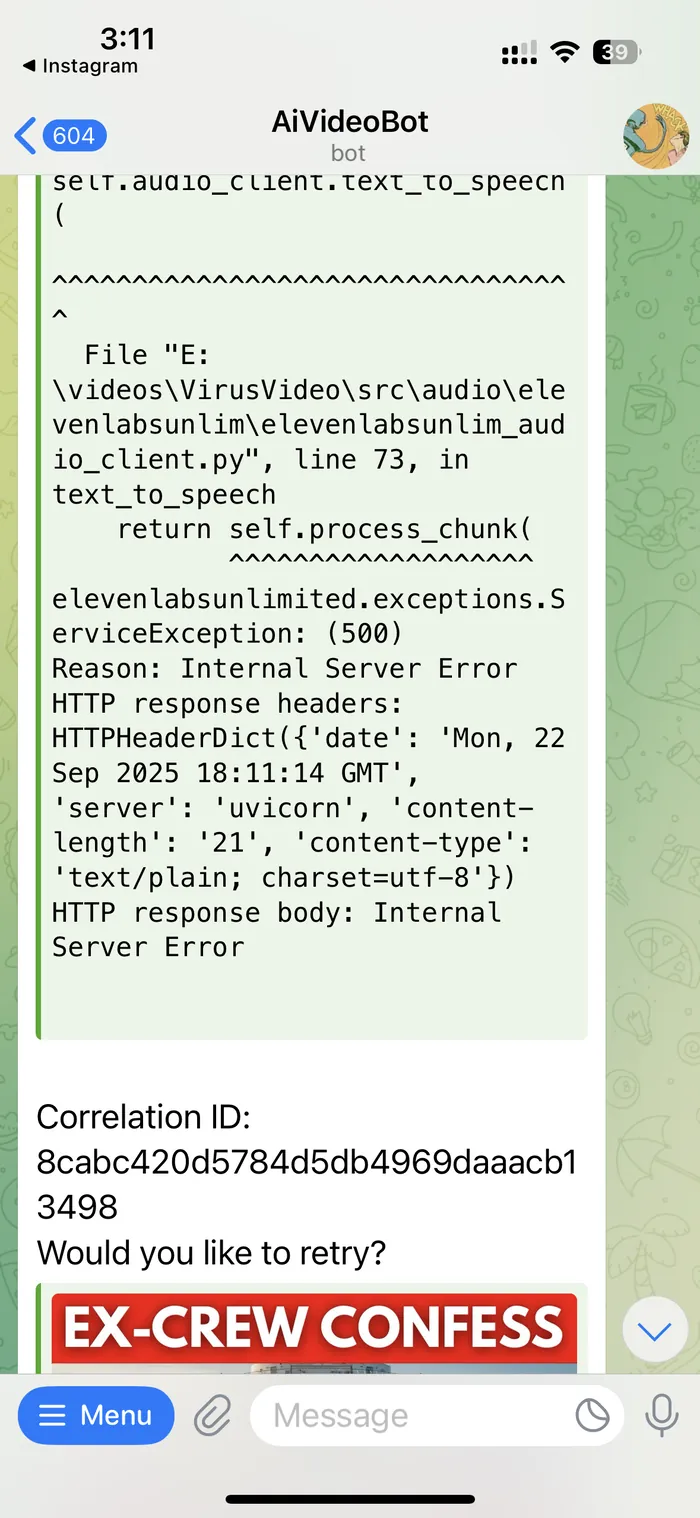
Entrada de referencias, solicitud de aprobación e informe de error con reintento
Guía para el equipo
Para el resto del equipo escribimos documentación de apoyo, para que también pudieran generar vídeos sobre la marcha. La guía explica cómo crear una tarea en el bot, qué hacer con las solicitudes de aprobación y los errores, y cómo trabajar en el cliente de escritorio RenderOrc. En la copia publicada los enlaces a carpetas en la nube y el nombre del bot están ocultos.
Ejecutores distribuidos
El lado ejecutor de esa misma cola. Varios workers se conectan a un único servidor de tareas, toman la siguiente - generar texto, transcribir audio, generar imágenes - y la ejecutan. En el pico había cinco máquinas de mi red local trabajando a la vez, una Steam Deck entre ellas, cada una con un cliente que se enganchaba al servidor y iba tomando tareas.
macOS, Windows y Linux
El desarrollo empezó en macOS, pero el cliente tenía que funcionar también en Windows y Linux, así que su stack se eligió pensando en las tres plataformas. En el pipeline final los ejecutores estaban mezclados: unas máquinas con macOS, otras con Linux y otras con Windows. Las capturas son de un ejecutor con Windows controlado desde un Mac por escritorio remoto: primero se instala el entorno de Python con sus dependencias y después el ejecutor renderiza el vídeo con Blender y procesa la pista de audio.
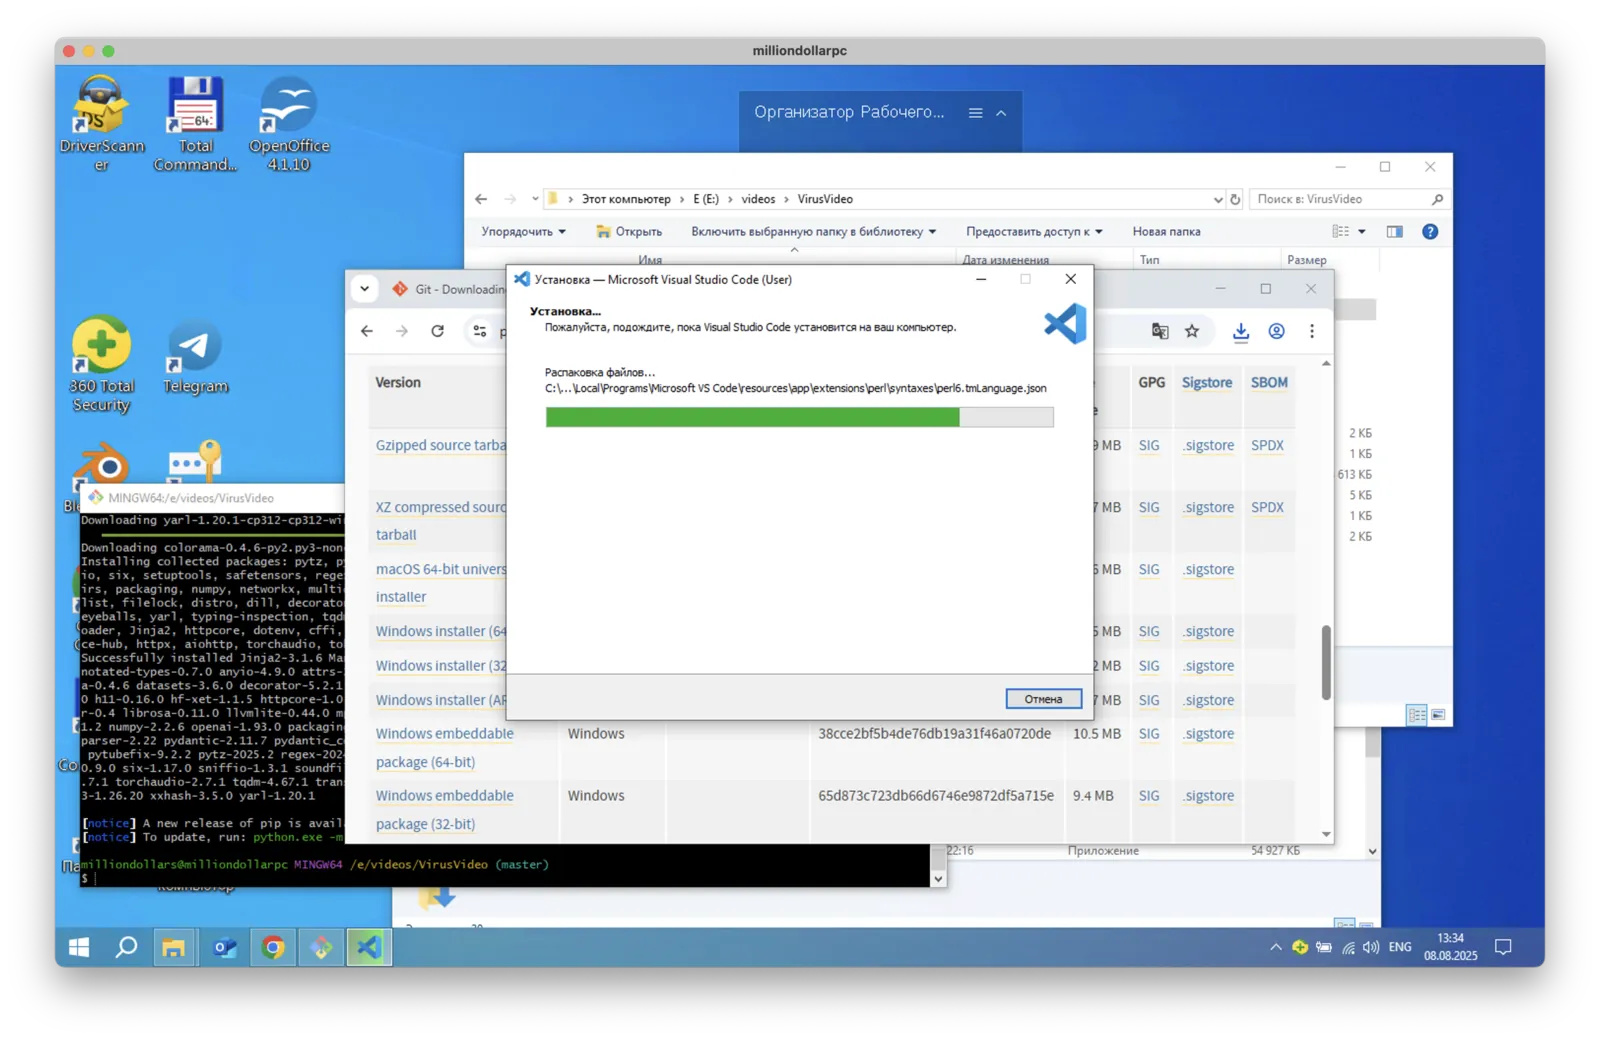
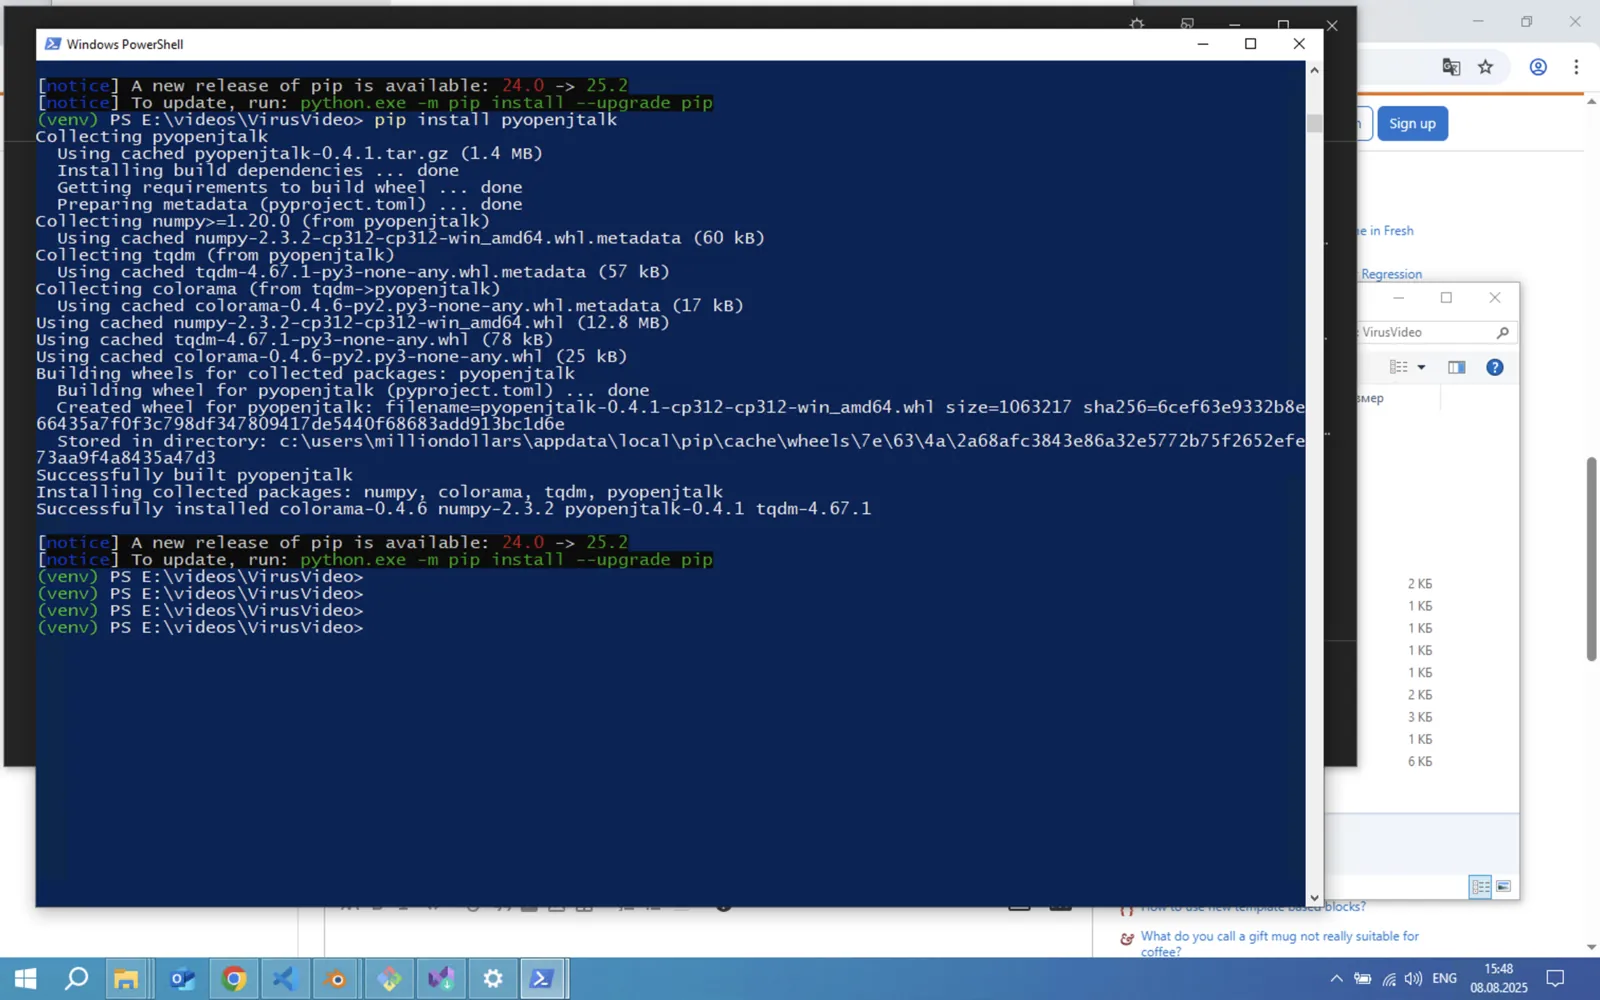
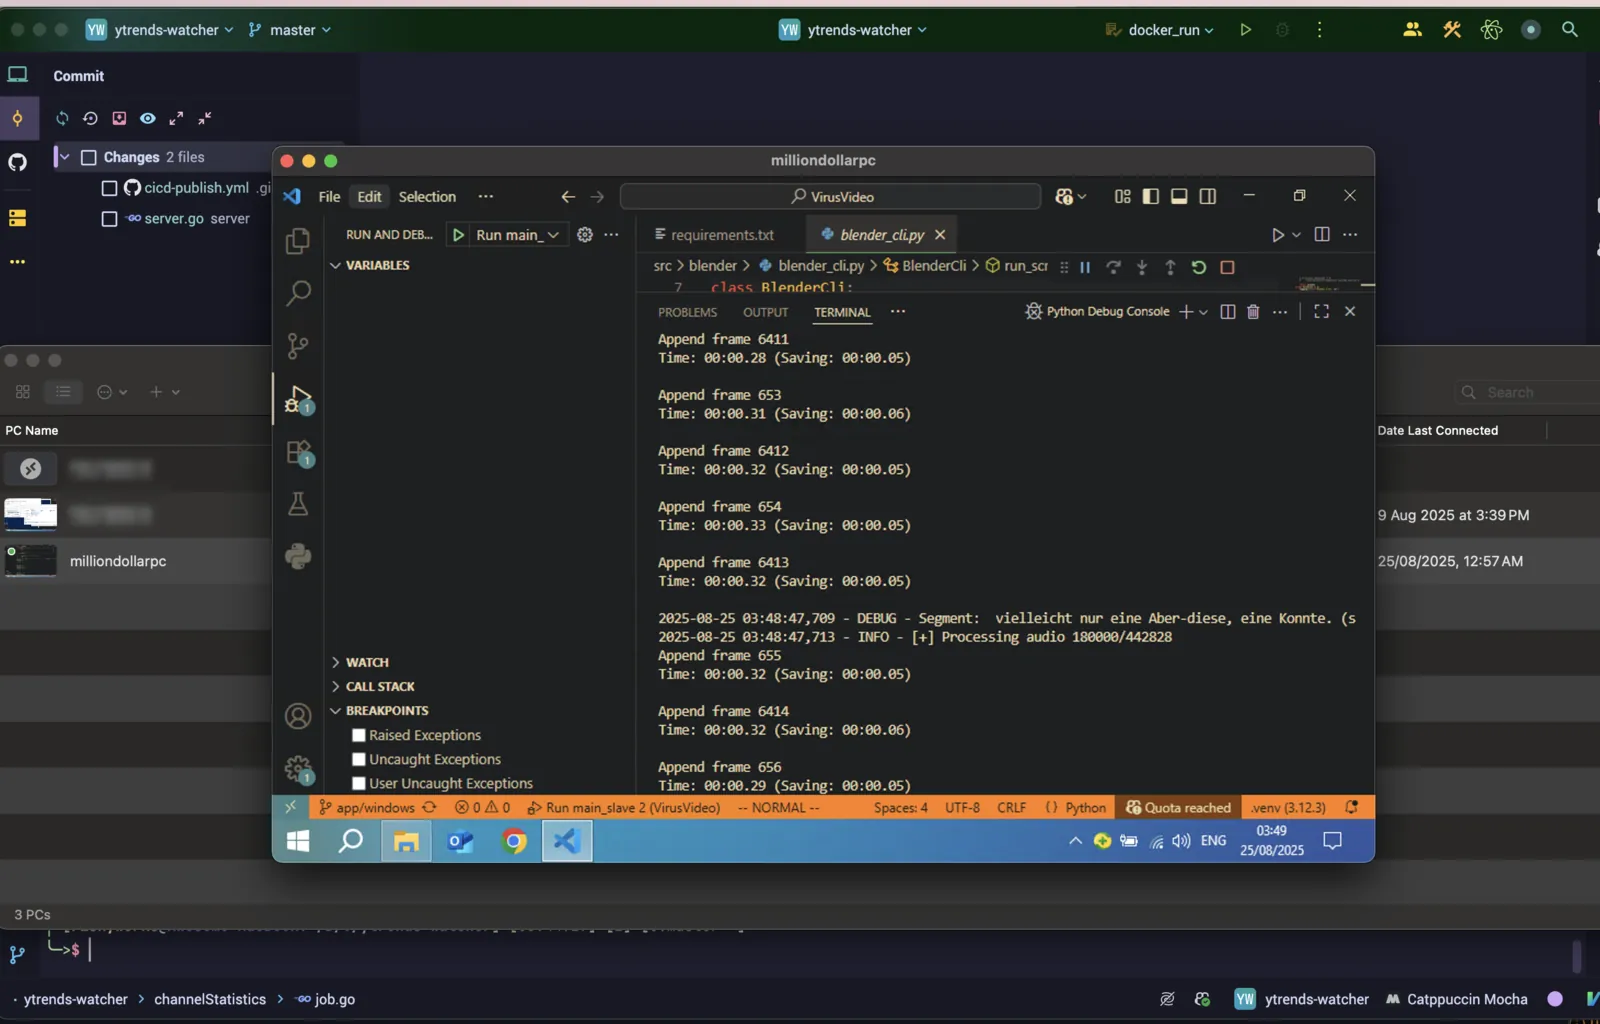
Un ejecutor con Windows: entorno, dependencias y render en Blender
Una fragua de contenido
Al final había tanto contenido por día que tuve que comprar un terabyte de Google Drive para mantener llena la cola de subida. Era literalmente una fragua de contenido, una cinta transportadora, una fábrica de contenido. El resultado eran videos en varios idiomas y de distintas duraciones, con toda la metainformación necesaria para subirlos a YouTube.
Cliente de escritorio para el visual
Corregir un solo fotograma malo a través de un bot de chat es incómodo, así que la parte visual tuvo su propio cliente de escritorio, RenderOrc. Abre un proyecto, lo lee y coloca la imagen de cada escena junto al prompt que la generó. El prompt se puede reescribir y esa escena regenerarse en el momento, sin relanzar la canalización ni buscar el fotograma en una carpeta.
RenderOrc funcionaba tanto en Windows como en macOS. Además de regenerar una imagen, la estilizaba para el vídeo: los avatares reciben una sombra, las imágenes de contenido una sombra y esquinas redondeadas, y una imagen menor que Full HD se coloca sobre un fondo con textura de papel. Cada imagen lleva el inicio y el fin de su escena, así que se puede comprobar contra el momento exacto que cubre, tanto por sentido como por estilo. Las capturas siguen al cliente desde una primera ventana de prompt hasta la aplicación terminada; debajo están las variantes de pantalla de inicio generadas para él.
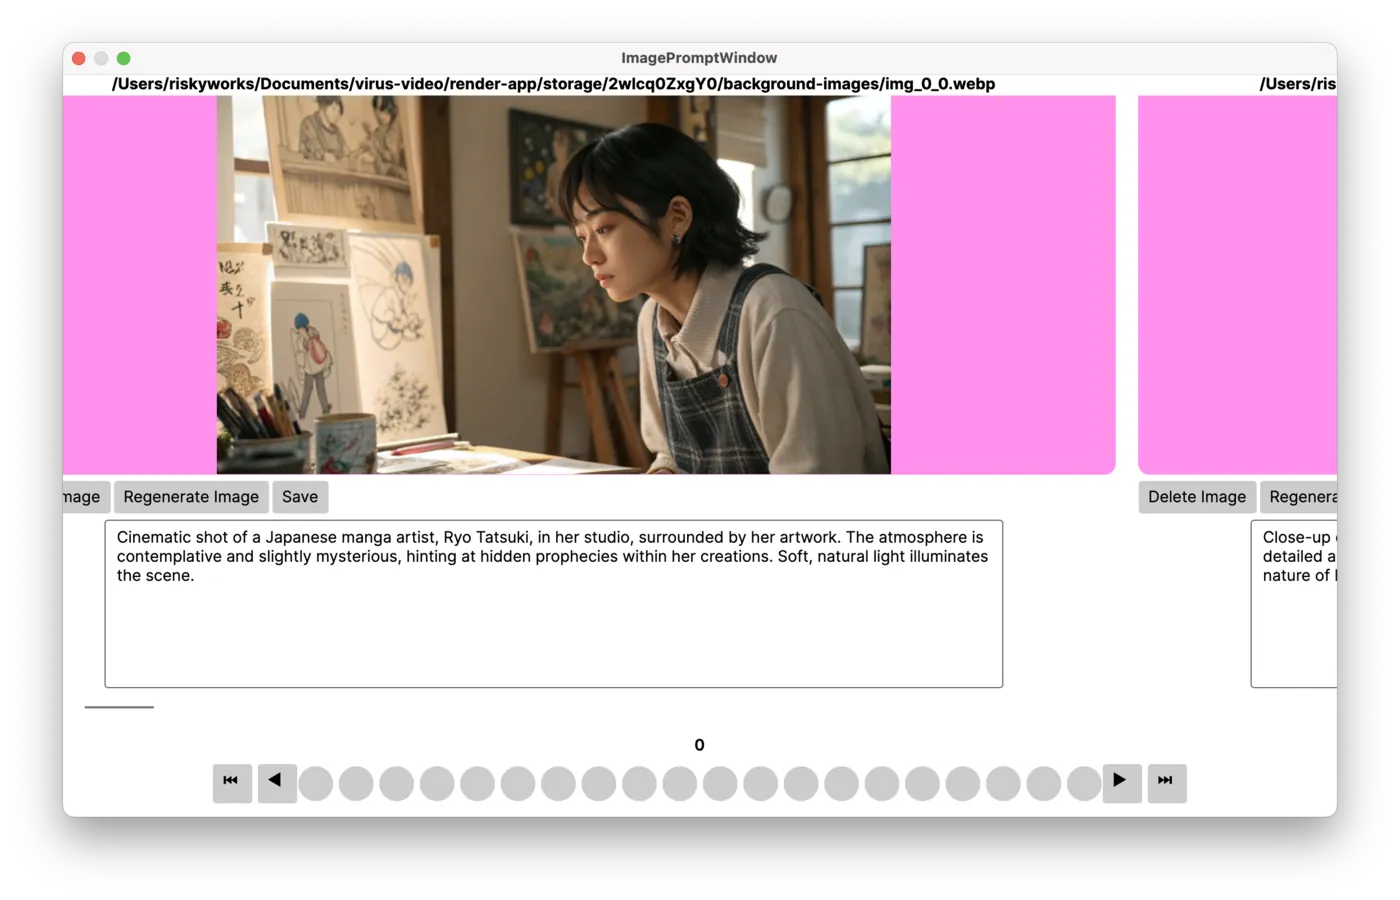
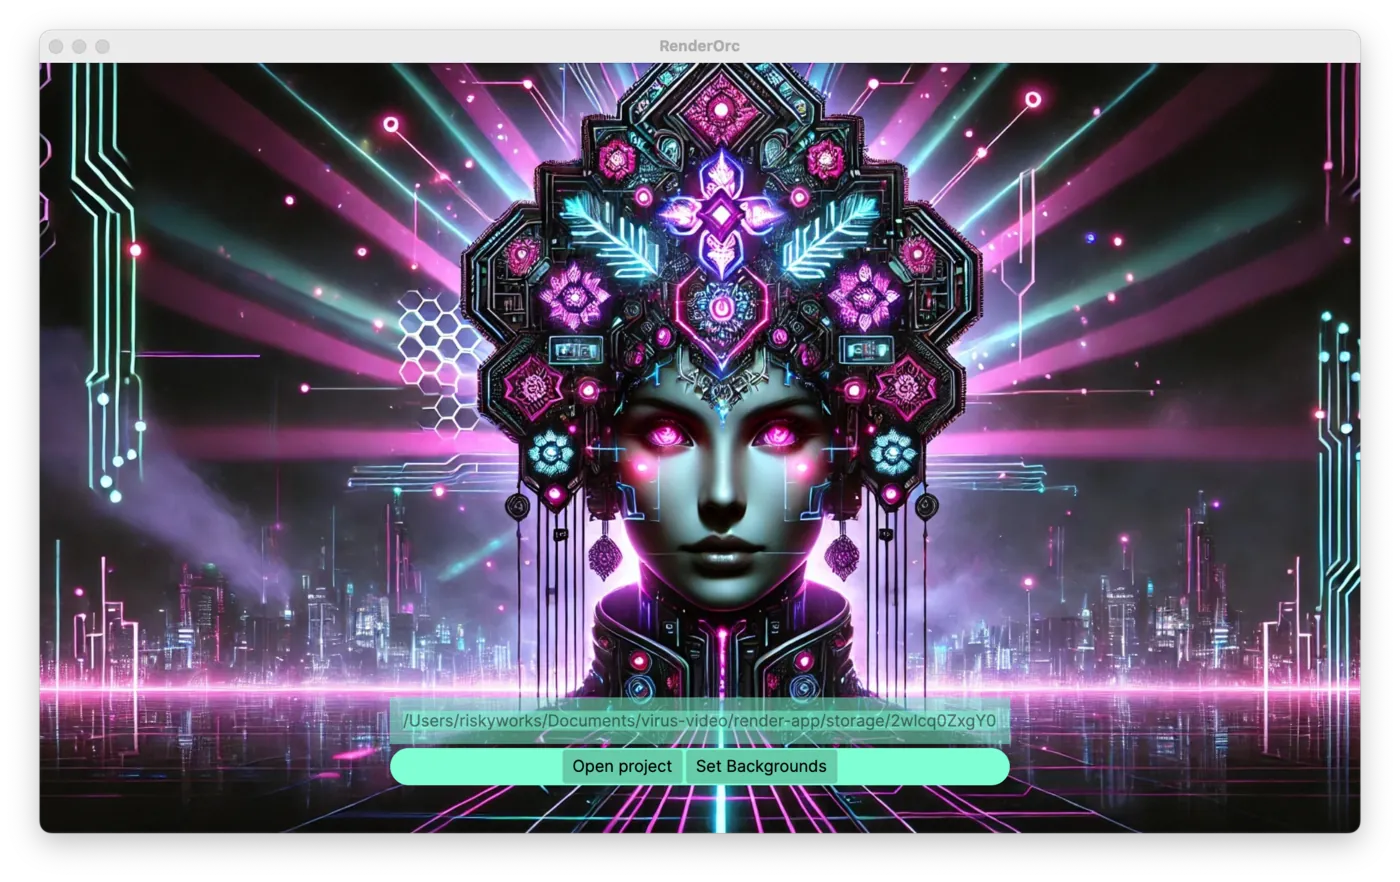
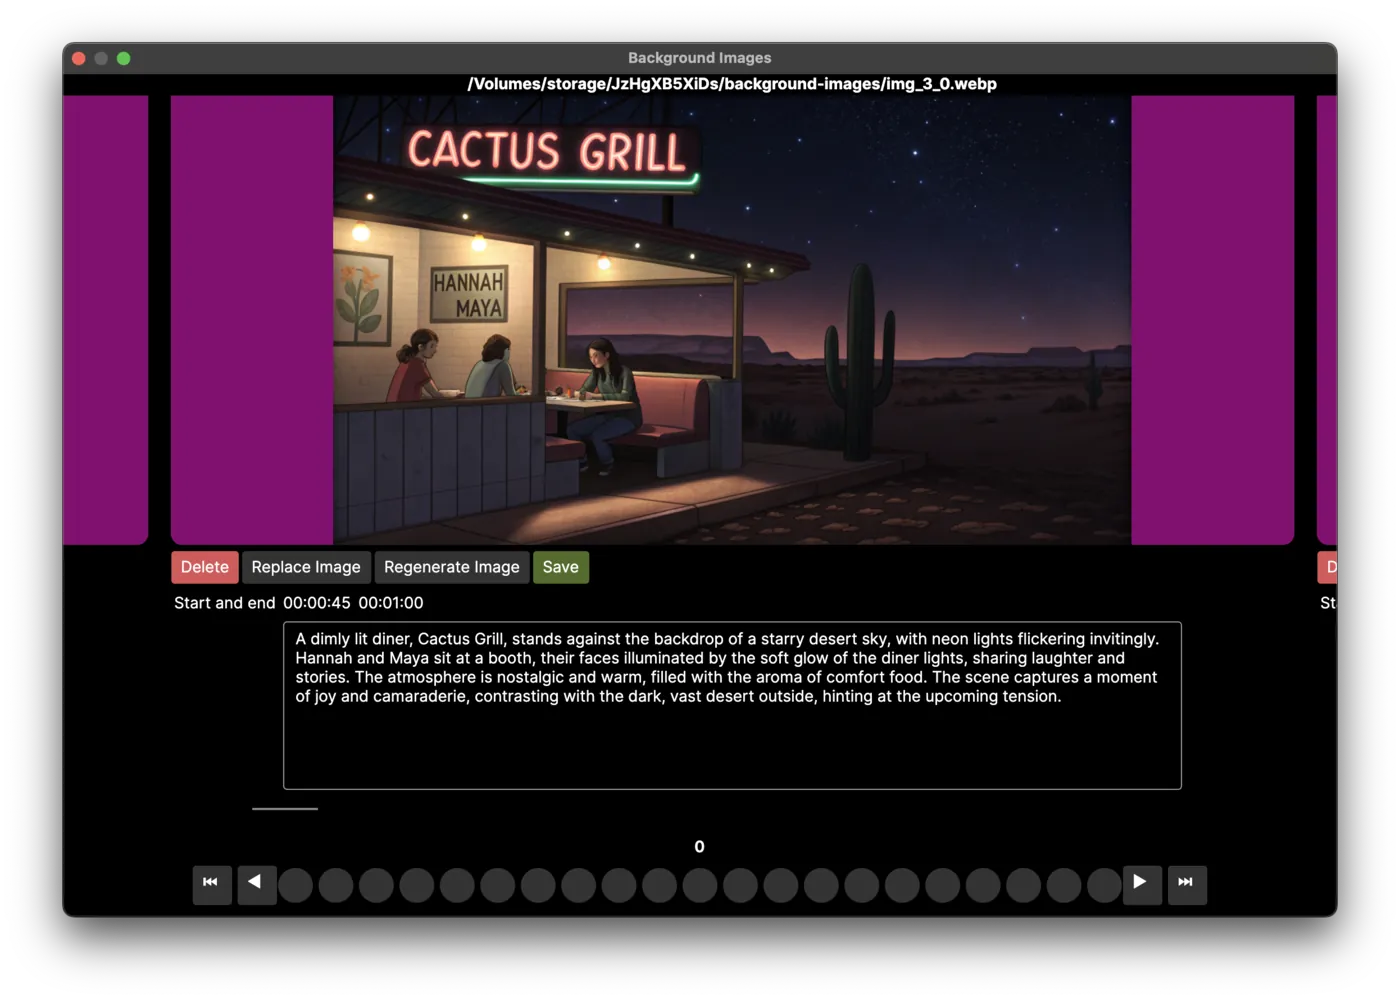
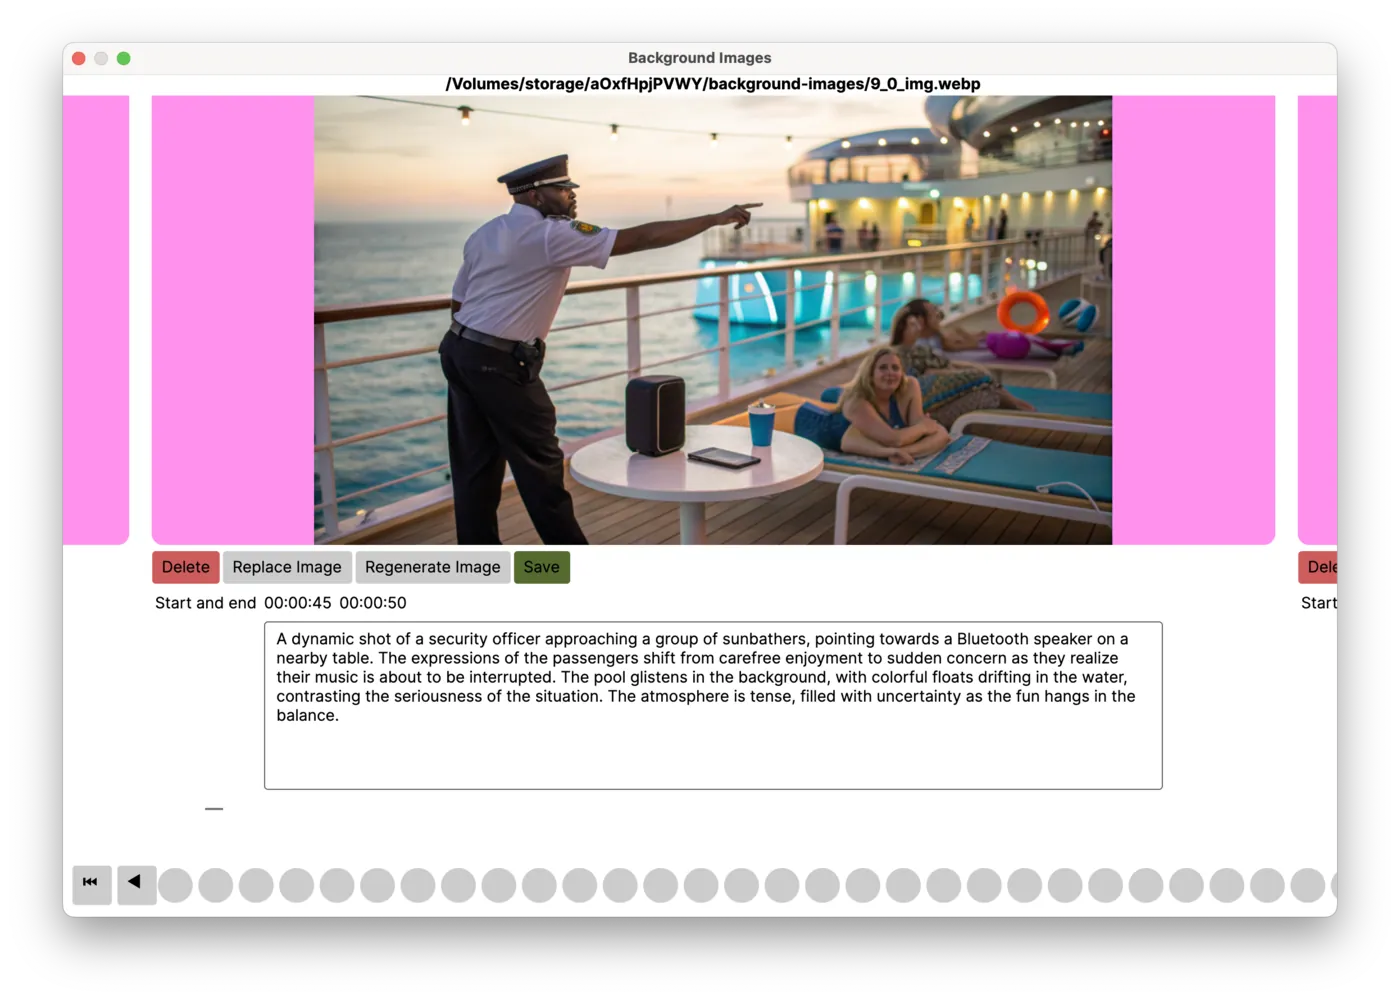
RenderOrc desde la primera ventana de prompt hasta el editor terminado
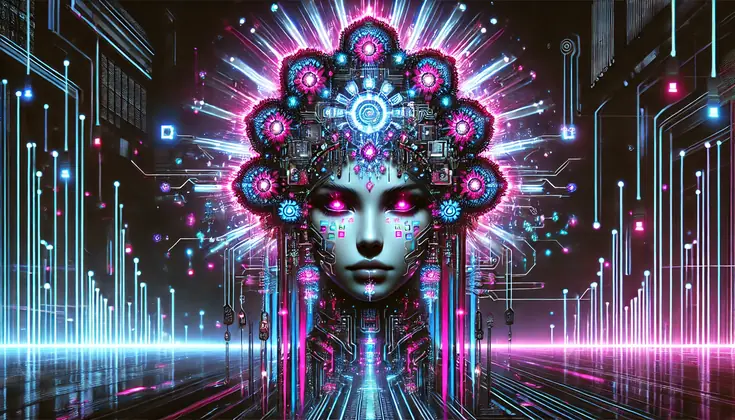
Variantes de pantalla de inicio generadas para RenderOrc
Monitorización de tendencias
Decidir qué producir a continuación pedía datos y no criterio personal, así que un microservicio aparte escrito en Go vigila una lista de canales añadidos y recoge lo que ha despegado en ellos. Esos vídeos forman el fondo de referencias con el que se construyen los briefs y los prompts de las portadas, que es de donde salen realmente los patrones virales descritos más arriba.
El propio watcher en marcha, recorriendo los canales vigilados.
Ampliación de la cuota de la API de YouTube
Monitorizar a esa escala choca con la cuota de la API de YouTube, así que se solicitó a Google un límite mayor para la recogida de estadísticas. La solicitud salió adelante. Poco después el proyecto se congeló, de modo que la cuota ampliada nunca llegó a aprovecharse del todo.
Relacionado
Proyectos
Traffic Connect: orquestación de contenido con IA para sitios WordPress
Antes: la generación de artículos con IA había que llevarla en muchos sitios WordPress, sin un lugar único para controlarla. Después: un solo panel de administración encola tareas para cada sitio, y cada sitio recoge las suyas a través de un plugin. Lo construí desde cero en más o menos un mes.
PREZA: sitios de presentaciones escolares con más de 80 000 PDF generados
Antes: los sitios de presentaciones escolares necesitaban decenas de miles de archivos listos que nadie podía hacer a mano. Después: grabbers, parsers y una generación automática en muchos hilos produjeron más de 80 000 PDF, guardados en el S3 en frío de Selectel y publicados en preza.kz y preza.top.
AtomPk Grabber: listados de productos a CSV cuando haga falta
Antes: un socio tenía que recopilar a mano, una y otra vez, el listado de productos de una web en CSV. Después: un ejecutable que se abre con doble clic, recorre el catálogo y escribe el CSV, sin instalar Python ni configurar nada.
Disponible para colaboración por contrato
Estoy disponible para colaborar por contrato. Si tiene una idea de proyecto interesante, reserve una llamada por Calendly.
Agenda una llamada de 30 min