Proyecto personal5 min de lectura
GDZ - Plataforma de Soluciones de Tareas
Tecnologías
Servicios
- →Arquitectura de canalización de generación de contenido con IA (Python + ChatGPT + Gemini)
- →Ingeniería de prompts consciente del plan de estudios por materia y grado
- →Configuración de plataforma multi-idioma y configuración SEO
- →Publicación automatizada en CMS y generación de sitemap
- →Canalización de validación de contenido para precisión educativa
Entregables
- ✓Miles de páginas estructuradas de soluciones de tareas en 3 idiomas (RU, PL, UA)
- ✓Canalización de generación automatizada, nuevo contenido añadido actualizando la entrada del plan de estudios
- ✓Tráfico de búsqueda orgánico desde el primer día tras el lanzamiento
- ✓Tres plataformas específicas por idioma desplegadas de forma independiente
Desafío
GDZ (gotovye domashnie zadaniya, soluciones de tareas listas) es una categoría EdTech consolidada en los mercados de habla rusa. La oportunidad: expandirse a los mercados polaco y ucraniano, donde existe la misma demanda pero la oferta es escasa. El problema: producir suficiente contenido educativo estructurado y de alta calidad para posicionarse en buscadores a escala es una operación de contenido masiva, demasiado lenta y costosa para hacerla manualmente.
Descubrimiento
Analizar la estructura del contenido reveló que las soluciones de tareas siguen plantillas predecibles: materia, grado, libro de texto, capítulo, ejercicio y luego solución con explicación paso a paso. La estructura es lo bastante consistente para generarse de forma sistemática. La variable es la calidad. Los LLM necesitaban un prompting y una validación cuidadosos para producir respuestas educativamente sólidas en lugar de un sinsentido con apariencia plausible.
Opciones consideradas
- Contratar redactores de contenido por idioma: descartado. La economía unitaria no funciona a escala; la varianza de calidad entre redactores es alta.
- Traducir el contenido ruso existente. Se usó parcialmente pero fue insuficiente. Los planes de estudio polaco y ucraniano difieren; la traducción directa produce respuestas incorrectas.
- Canalizaciones de generación con IA con prompting consciente del plan de estudios, elegido. ChatGPT y Gemini con prompts estructurados ajustados por materia y grado producen soluciones precisas y paso a paso a la escala requerida.
Decisión
Las canalizaciones en Python consumen datos del plan de estudios (metadatos de libros de texto, listas de ejercicios) y generan soluciones a través de las API de ChatGPT y Gemini. La salida se valida contra los formatos de respuesta esperados, se estructura según el esquema de datos del sitio y se publica en el dominio del idioma correspondiente. Los metadatos SEO se generan junto con el contenido.
Implementación
Se construyó una canalización de varias etapas: ingestión del plan de estudios y luego construcción del prompt por materia/grado/ejercicio, generación paralela con LLM, validación de salida estructurada y luego publicación en el CMS. Cada etapa tiene manejo de errores y una cola de revisión para los casos límite que señala el validador. Se usan modelos distintos según el tipo de materia: Gemini se desenvuelve bien con matemáticas y ciencias; ChatGPT-4o rinde mejor en humanidades y materias de idiomas.
Se lanzaron tres plataformas específicas por idioma: gdzclass.ru (RU), domowapraca.com (PL), padruchnik.com (UA). Cada dominio se despliega de forma independiente con configuración SEO específica por idioma, estructura de enlazado interno y generación de sitemap.
OCR para libros de texto en kazajo
Añadir nuevos libros de texto implica digitalizar muchas páginas, y una parte está en kazajo. Los motores de OCR disponibles manejan ese idioma bastante mal, así que una canalización con un solo motor no daba la talla.
Lo que funcionó fue una solución combinada: Tesseract y PaddleOCR juntos, cada uno cubriendo donde falla el otro. El código Python se depuró en notebooks de Google Colab, sencillamente más rápido para iterar que un entorno local.
Reconocimiento de una página en kazajo.
Resultados sobre texto con formato y tablas, las composiciones que rompen antes a un OCR ingenuo.
Digitalizar los libros
Una de las tareas fue digitalizar los libros de texto para su reconocimiento. Compramos los originales y los escaneamos, pero la calidad de los escaneos dejaba mucho que desear, así que cada página pasaba por una red neuronal que multiplicaba su calidad. Con el resultado el OCR trabajaba mucho mejor.
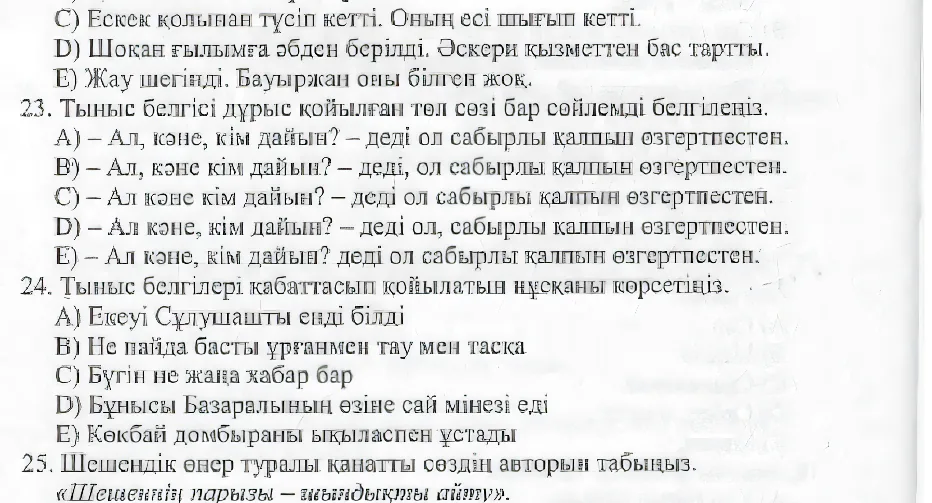
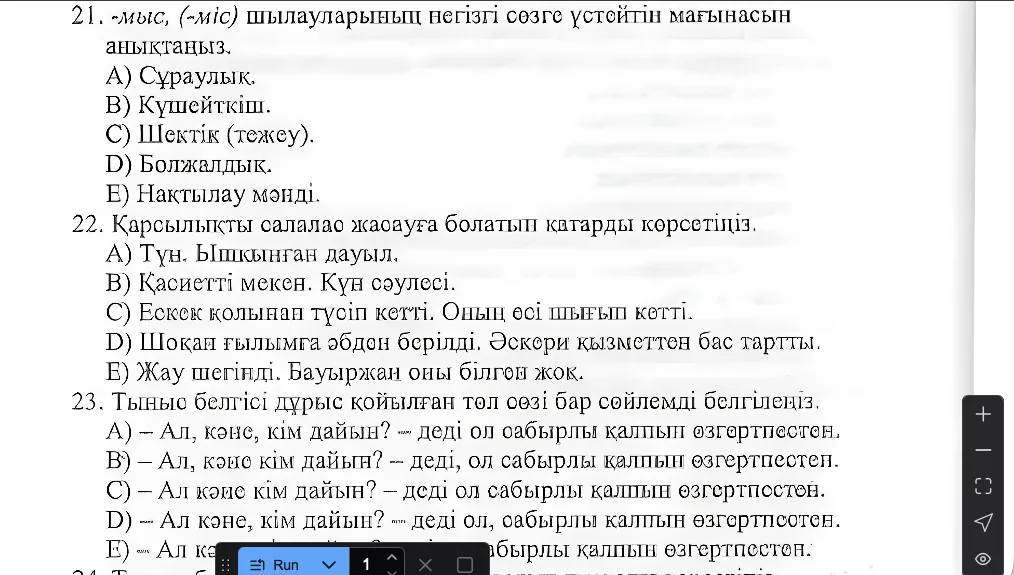
Antes y después de mejorar la calidad
Elegir las herramientas de OCR
Probamos varios enfoques y muchas librerías para reconocer el texto: Tesseract, PaddleOCR, Docling y Pix2Text con sus modelos aparte para fórmulas y tablas. El texto corriente fue la parte fácil. El verdadero reto fueron las tablas y las fórmulas: primero un modelo de maquetación tenía que encontrarlas en la página, y las fórmulas salían en LaTeX, que con las matemáticas escaneadas se rompía a menudo.
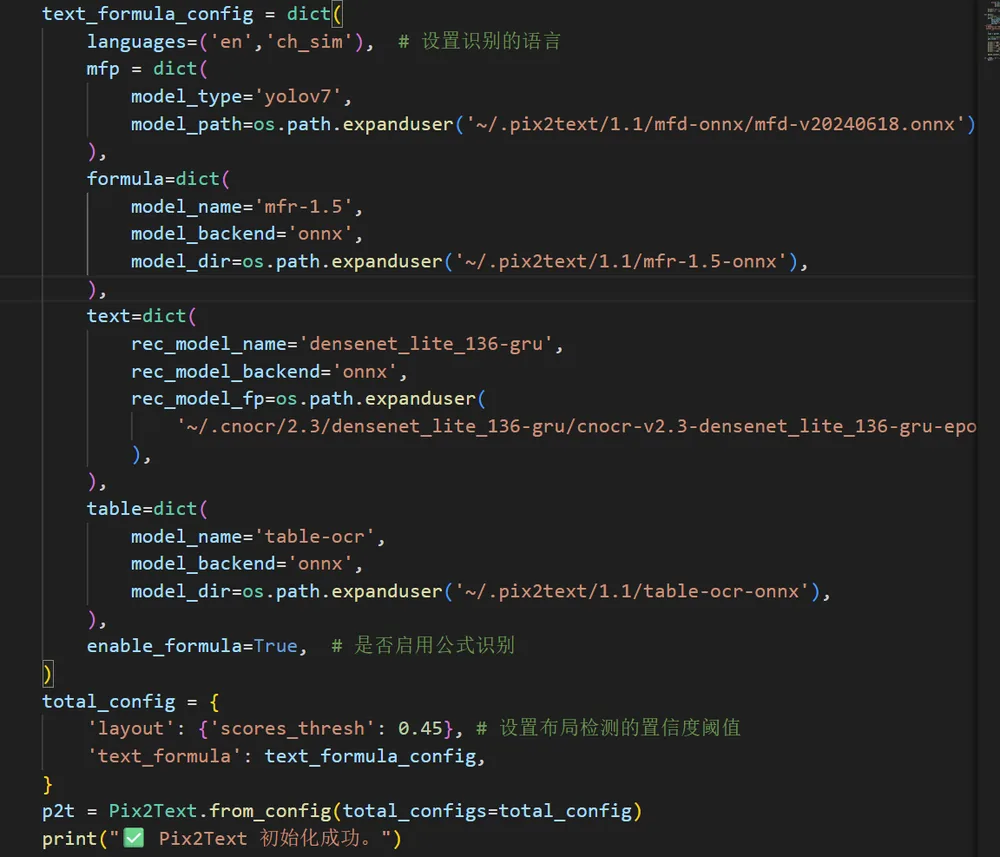
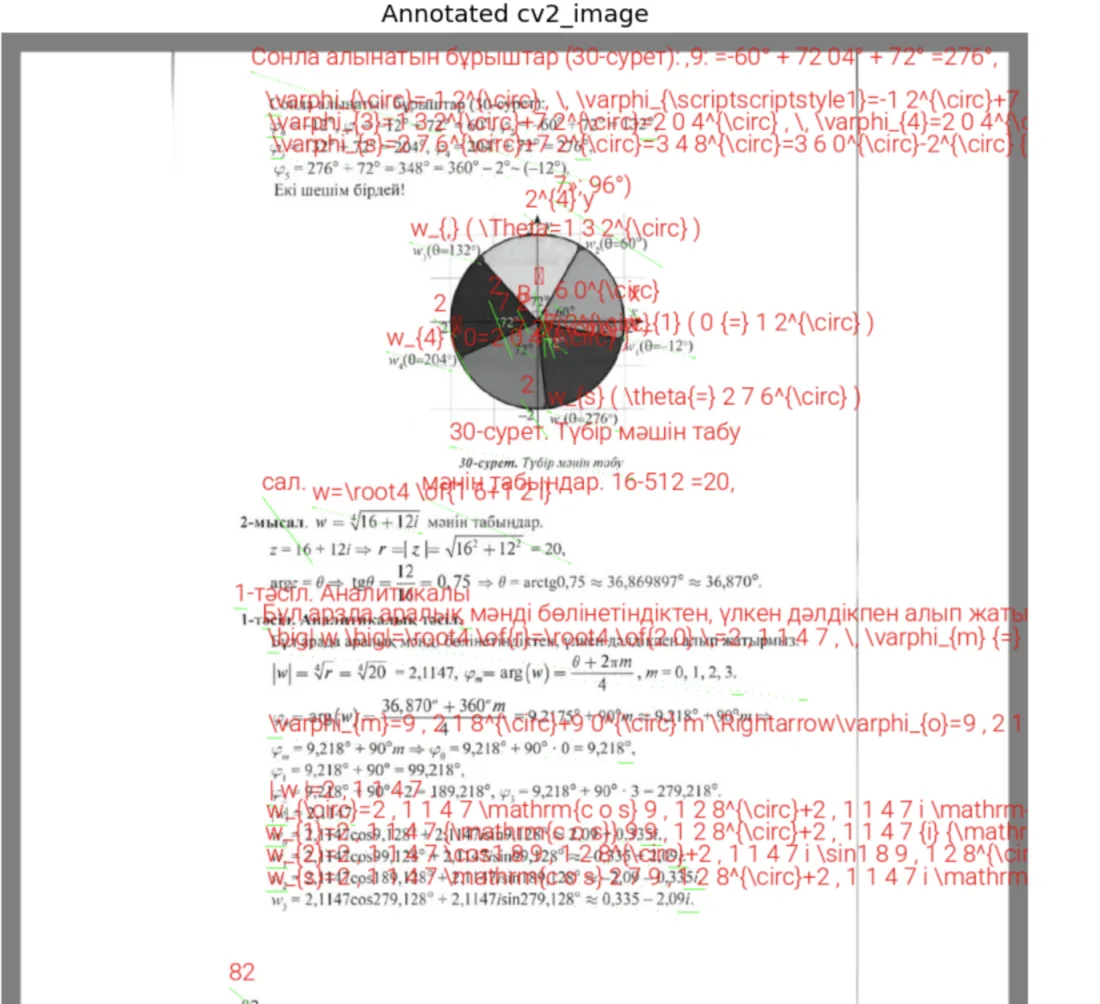
La configuración de Pix2Text y una página de fórmulas que le costaba
Las tablas y el idioma kazajo
Las tablas dieron más trabajo que nada. Al final funcionó una solución combinada: un modelo reconocía la estructura de la tabla y otro leía el contenido de cada celda. El idioma lo complicaba aún más: la mayoría de los libros estaban en kazajo, y tanto Tesseract como PaddleOCR lo soportan solo en parte, así que también el texto necesitó una solución combinada en la que cada motor cubre los huecos del otro.
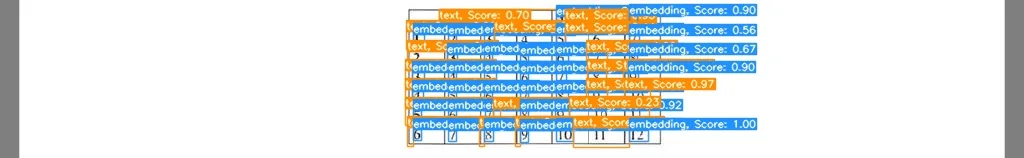
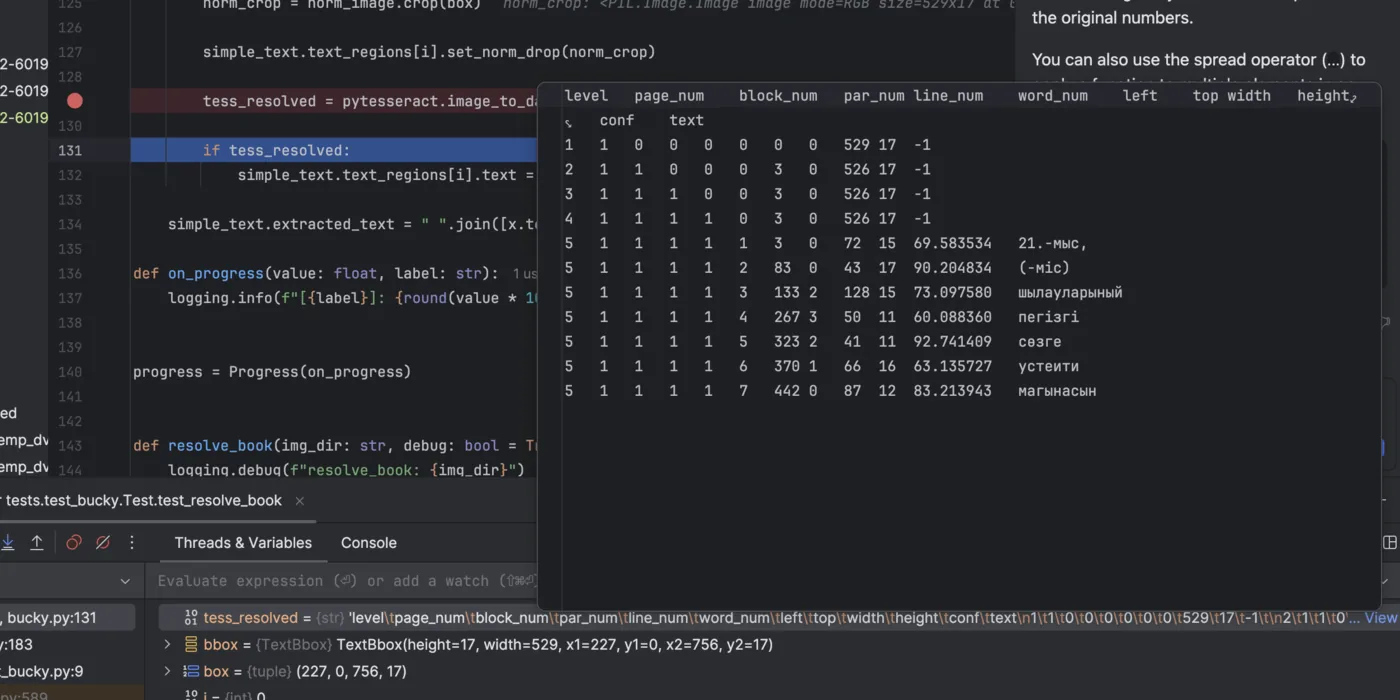
Detección de la estructura de la tabla y salida de Tesseract en texto kazajo
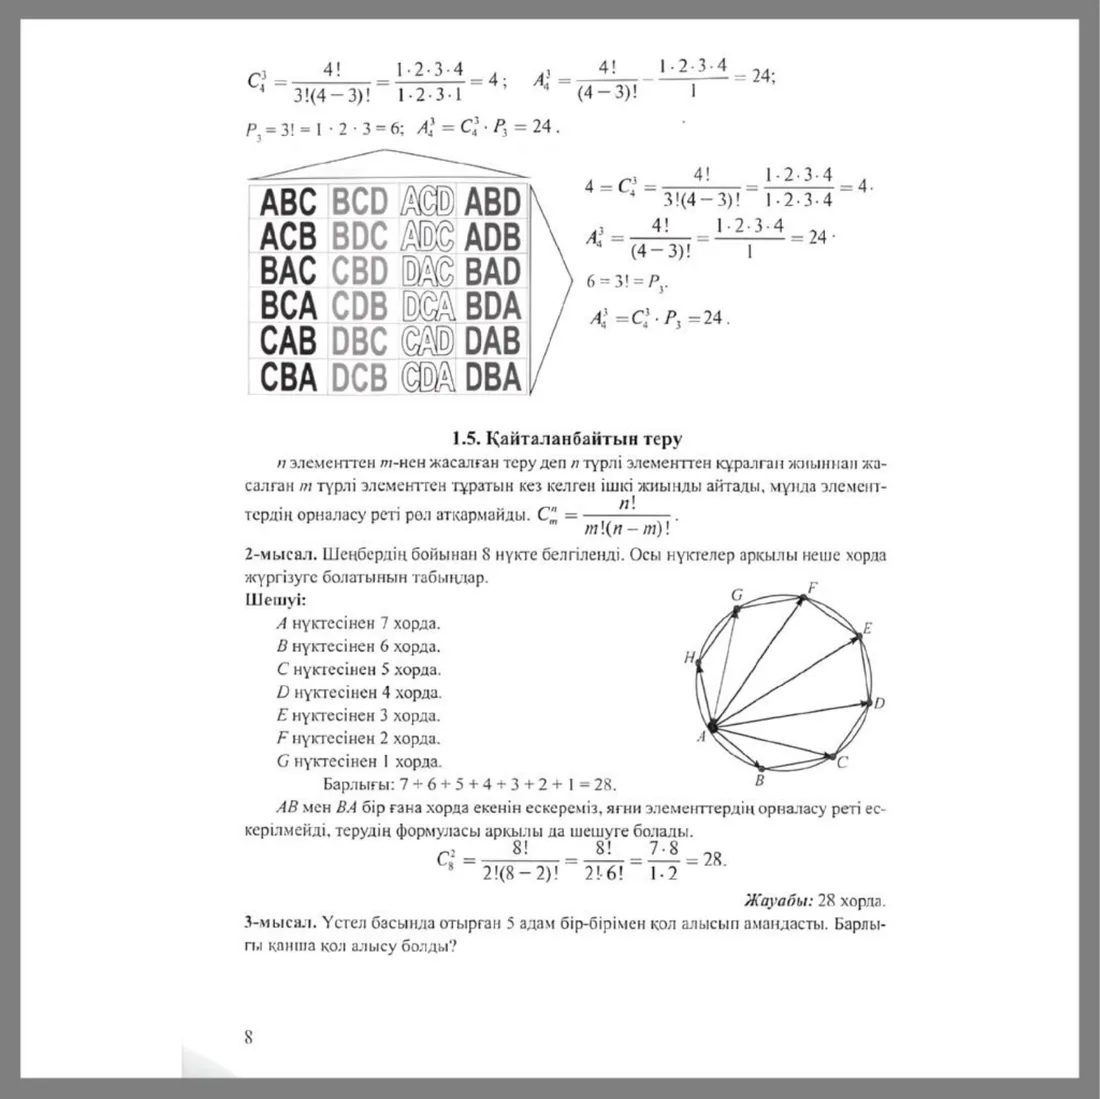
Páginas como esta eran una auténtica pesadilla: una fórmula, una tabla, una ilustración y texto en kazajo en la misma página. El pipeline final las procesaba de forma combinada. Las ilustraciones se detectaban y se guardaban como imágenes aparte, las fórmulas se convertían a notación LaTeX y las tablas pasaban por un proceso propio que primero leía la estructura y después escaneaba cada celda.
Resultado
Miles de páginas de contenido estructurado publicadas en tres idiomas sin un crecimiento proporcional de plantilla. El tráfico de búsqueda orgánico comenzó a acumularse desde las primeras semanas tras el lanzamiento a medida que las páginas se indexaban. La arquitectura de la canalización permite añadir nuevos grados, materias o libros de texto actualizando la entrada del plan de estudios, sin cambios de código.
Relacionado
Proyectos
Traffic Connect: orquestación de contenido con IA para sitios WordPress
Antes: la generación de artículos con IA había que llevarla en muchos sitios WordPress, sin un lugar único para controlarla. Después: un solo panel de administración encola tareas para cada sitio, y cada sitio recoge las suyas a través de un plugin. Lo construí desde cero en más o menos un mes.
PREZA: sitios de presentaciones escolares con más de 80 000 PDF generados
Antes: los sitios de presentaciones escolares necesitaban decenas de miles de archivos listos que nadie podía hacer a mano. Después: grabbers, parsers y una generación automática en muchos hilos produjeron más de 80 000 PDF, guardados en el S3 en frío de Selectel y publicados en preza.kz y preza.top.
AtomPk Grabber: listados de productos a CSV cuando haga falta
Antes: un socio tenía que recopilar a mano, una y otra vez, el listado de productos de una web en CSV. Después: un ejecutable que se abre con doble clic, recorre el catálogo y escribe el CSV, sin instalar Python ni configurar nada.
Disponible para colaboración por contrato
Estoy disponible para colaborar por contrato. Si tiene una idea de proyecto interesante, reserve una llamada por Calendly.
Agenda una llamada de 30 min