Личный проект4 мин чтения
ГДЗ - платформа готовых домашних заданий
Технологии
Услуги
- →Архитектура пайплайна ИИ-генерации контента (Python + ChatGPT + Gemini)
- →Промпт-инжиниринг с учётом учебной программы по каждому предмету и классу
- →Настройка мультиязычной платформы и SEO-конфигурация
- →Автоматическая публикация в CMS и генерация sitemap
- →Пайплайн валидации контента на образовательную корректность
Результаты
- ✓Тысячи структурированных страниц с решениями домашних заданий для 3 локалей (RU, PL, UA)
- ✓Автоматический пайплайн генерации - новый контент добавляется обновлением данных учебной программы
- ✓Органический поисковый трафик с первого дня после запуска
- ✓Три независимо развёрнутые платформы под конкретные локали
Задача
ГДЗ (готовые домашние задания) - устоявшаяся EdTech-категория на русскоязычных рынках. Возможность: выйти на польский и украинский рынки, где тот же спрос есть, но предложение скудное. Проблема: производство достаточного объёма качественного структурированного образовательного контента для ранжирования в поиске на масштабе - это огромная контент-операция, слишком медленная и дорогая, чтобы делать её вручную.
Исследование
Анализ структуры контента показал, что решения домашних заданий следуют предсказуемым шаблонам: предмет и затем класс, учебник, глава, упражнение и затем решение с пошаговым объяснением. Структура достаточно единообразна, чтобы генерировать её систематически. Переменная - качество: LLM требовали тщательного промптинга и валидации, чтобы выдавать образовательно корректные ответы, а не правдоподобную чепуху.
Рассмотренные варианты
- Нанять копирайтеров под каждую локаль - отклонено. Юнит-экономика не сходится на масштабе; разброс качества между авторами велик.
- Перевести существующий русский контент - частично использовано, но недостаточно. Польская и украинская школьные программы отличаются; прямой перевод даёт неверные ответы.
- ИИ-пайплайны генерации с промптингом с учётом учебной программы - выбрано. ChatGPT и Gemini со структурированными промптами, настроенными под предмет и класс, выдают точные пошаговые решения в нужном масштабе.
Решение
Пайплайны на Python принимают данные учебной программы (метаданные учебников, списки упражнений) и генерируют решения через API ChatGPT и Gemini. Результат валидируется по ожидаемым форматам ответов, структурируется в схему данных сайта и публикуется на соответствующем домене локали. SEO-метаданные генерируются вместе с контентом.
Реализация
Построен многоэтапный пайплайн: загрузка учебной программы, построение промпта под предмет/класс/упражнение и затем параллельная генерация LLM, валидация структурированного вывода и затем публикация в CMS. На каждом этапе есть обработка ошибок и очередь на проверку для пограничных случаев, которые помечает валидатор. Под разные типы предметов используются разные модели: Gemini хорошо справляется с математикой и естественными науками; ChatGPT-4o лучше работает с гуманитарными и языковыми предметами.
Запущены три платформы под конкретные локали: gdzclass.ru (RU), domowapraca.com (PL), padruchnik.com (UA). Каждый домен развёрнут независимо со своей SEO-конфигурацией под локаль, структурой внутренней перелинковки и генерацией sitemap.
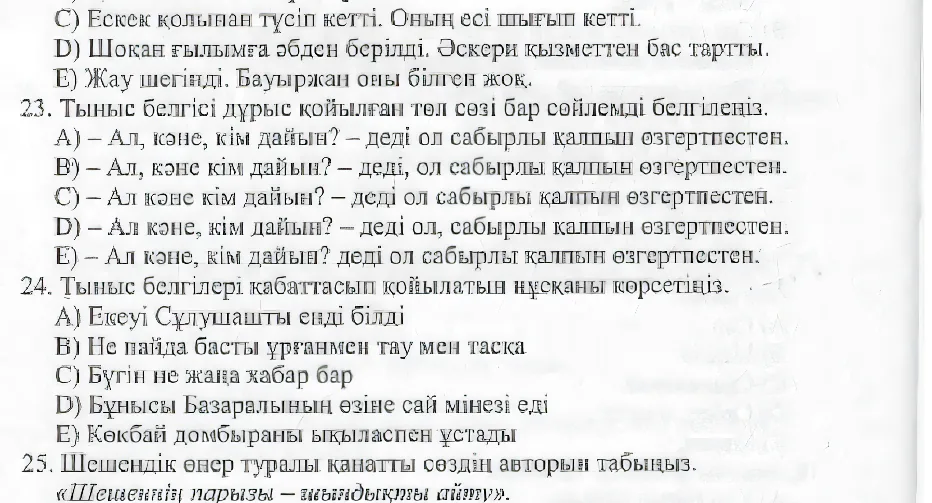
OCR для учебников на казахском
Добавление новых учебников означает оцифровку большого количества страниц, и часть из них - на казахском. Доступные OCR-движки этот язык поддерживают весьма посредственно, так что на одном движке конвейер было не вытянуть.
Сработало комбинированное решение: Tesseract и PaddleOCR вместе, каждый закрывает то, где промахивается другой. Код на Python отлаживал в блокнотах Google Colab - так итерации идут быстрее, чем на локальной машине.
Распознавание страницы на казахском языке.
Результаты на форматированном тексте и таблицах - раскладках, на которых наивный OCR ломается первым.
Оцифровка книг
Одной из задач была оцифровка учебников для распознавания. Мы купили оригиналы и отсканировали их, но качество сканов оставляло желать лучшего, поэтому каждую страницу прогоняли через нейросеть, которая кратно повышала качество изображения. С результатом OCR работал уже гораздо увереннее.
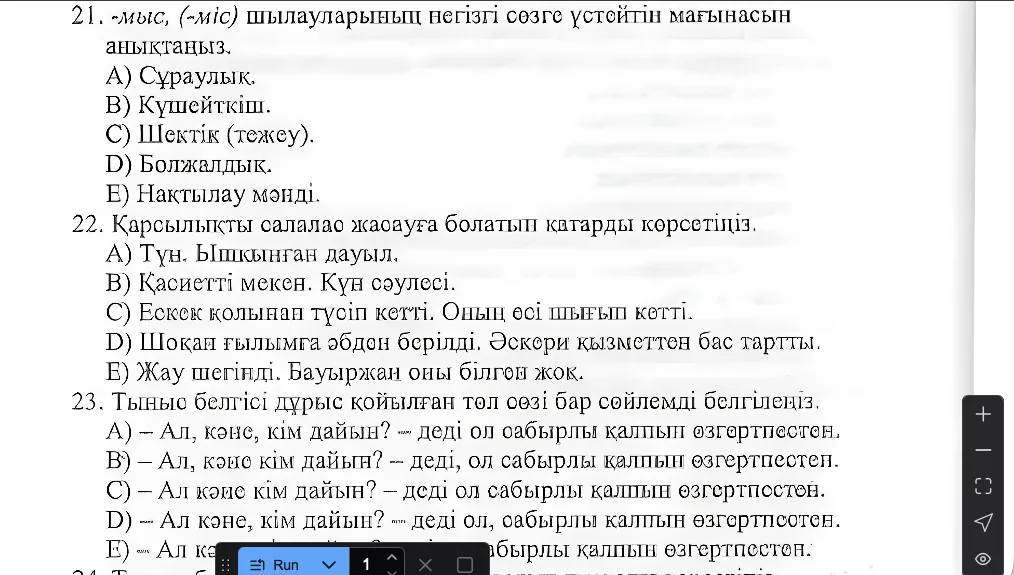
До и после повышения качества
Выбор инструментов OCR
Мы рассмотрели несколько подходов и перебрали множество библиотек для распознавания текста: Tesseract, PaddleOCR, Docling и Pix2Text с отдельными моделями для формул и таблиц. Обычный текст оказался самой простой частью. Особым челленджем стали таблицы и формулы: сначала модель разметки должна найти их на странице, а формулы возвращались в LaTeX, который на отсканированной математике часто ломался.
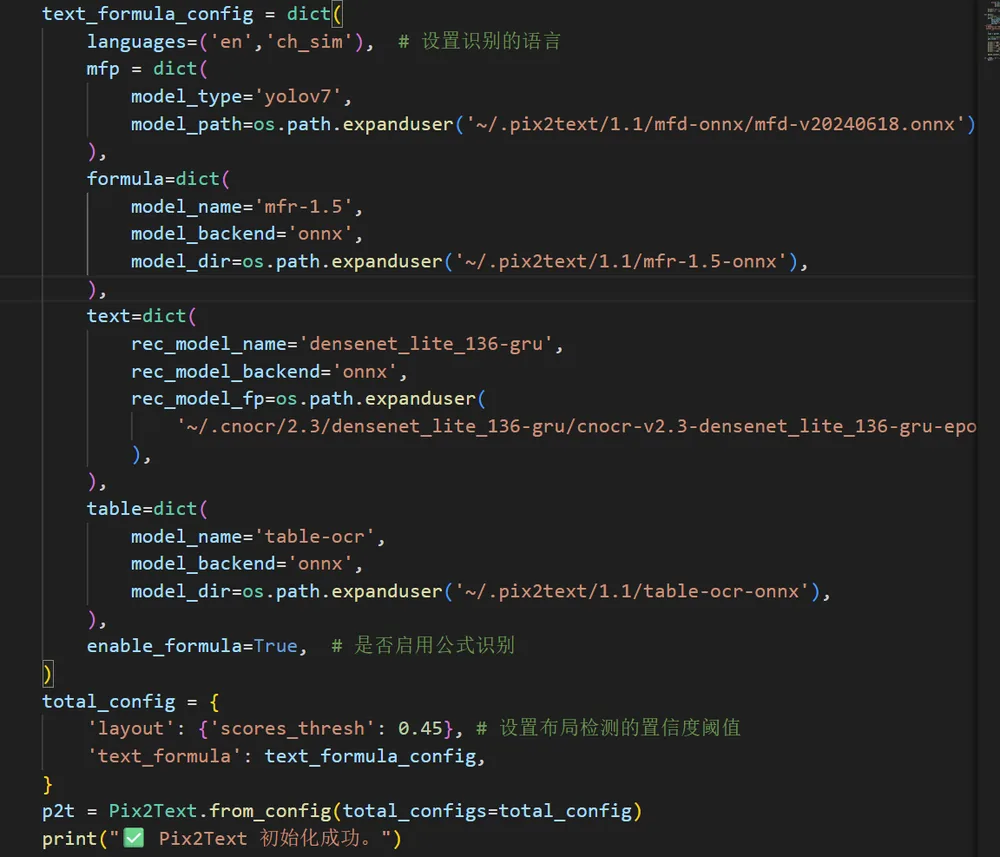
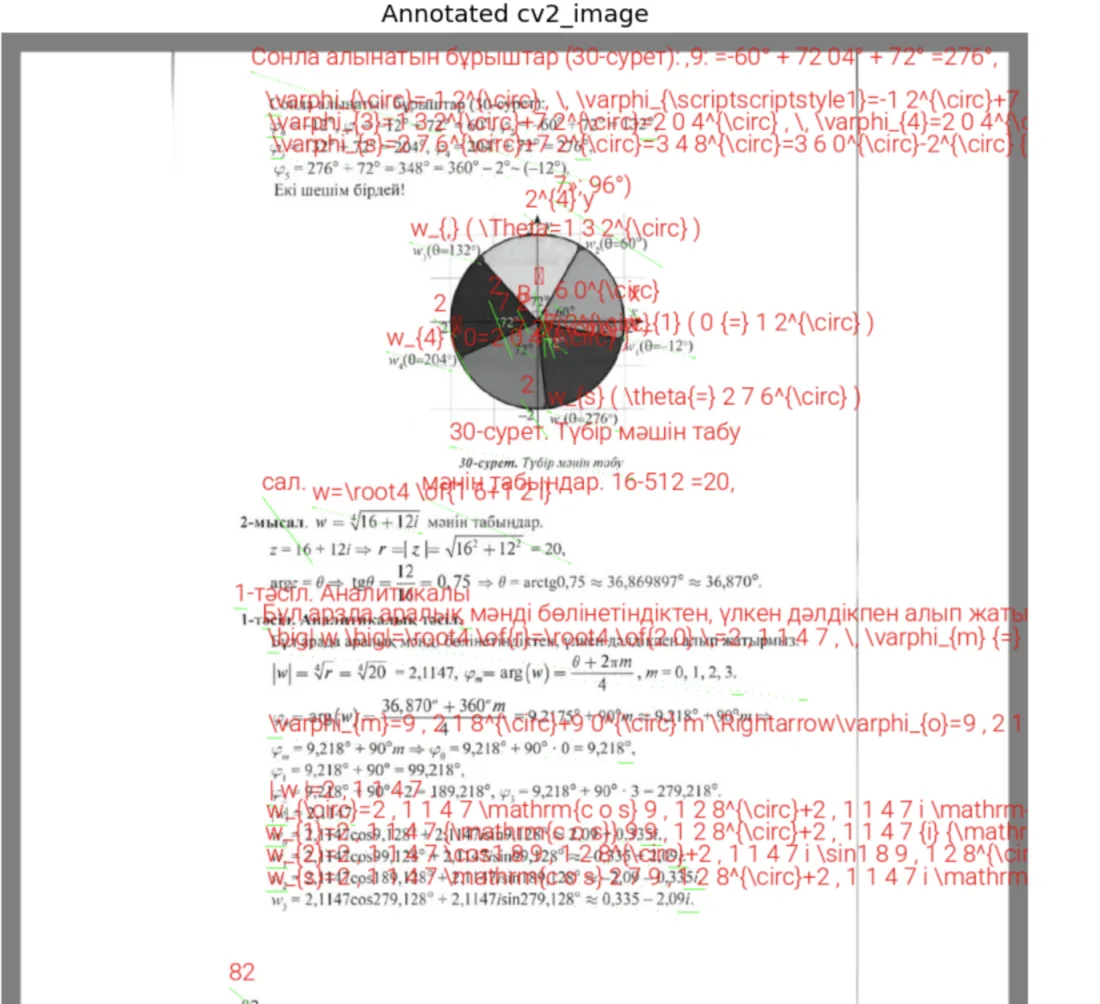
Настройка Pix2Text и страница с формулами, на которой он спотыкался
Таблицы и казахский язык
С таблицами было больше всего заморочек. Победить их удалось комбинированным решением: одна модель распознавала шаблон таблицы, а другая читала содержимое каждой ячейки. Сложности добавлял язык: большинство книг были на казахском, а Tesseract и PaddleOCR поддерживают его лишь частично, поэтому и для самого текста пришлось собирать комбинированное решение, где каждый движок закрывает пробелы другого.
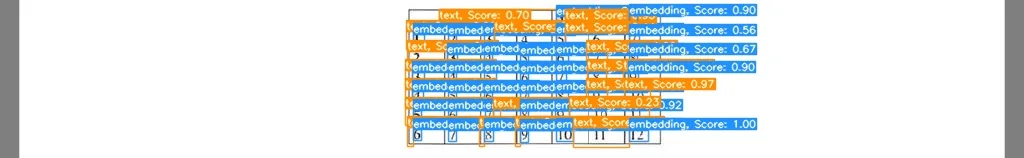
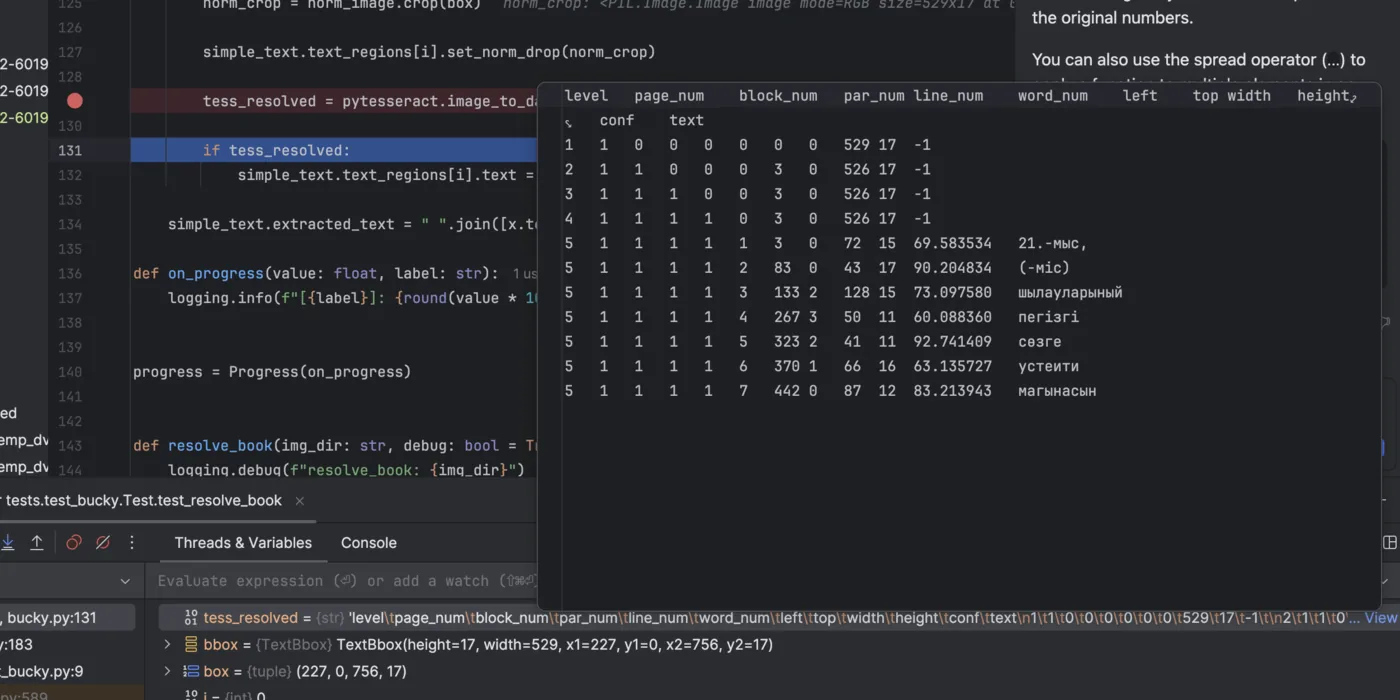
Распознавание структуры таблицы и вывод Tesseract на казахском тексте
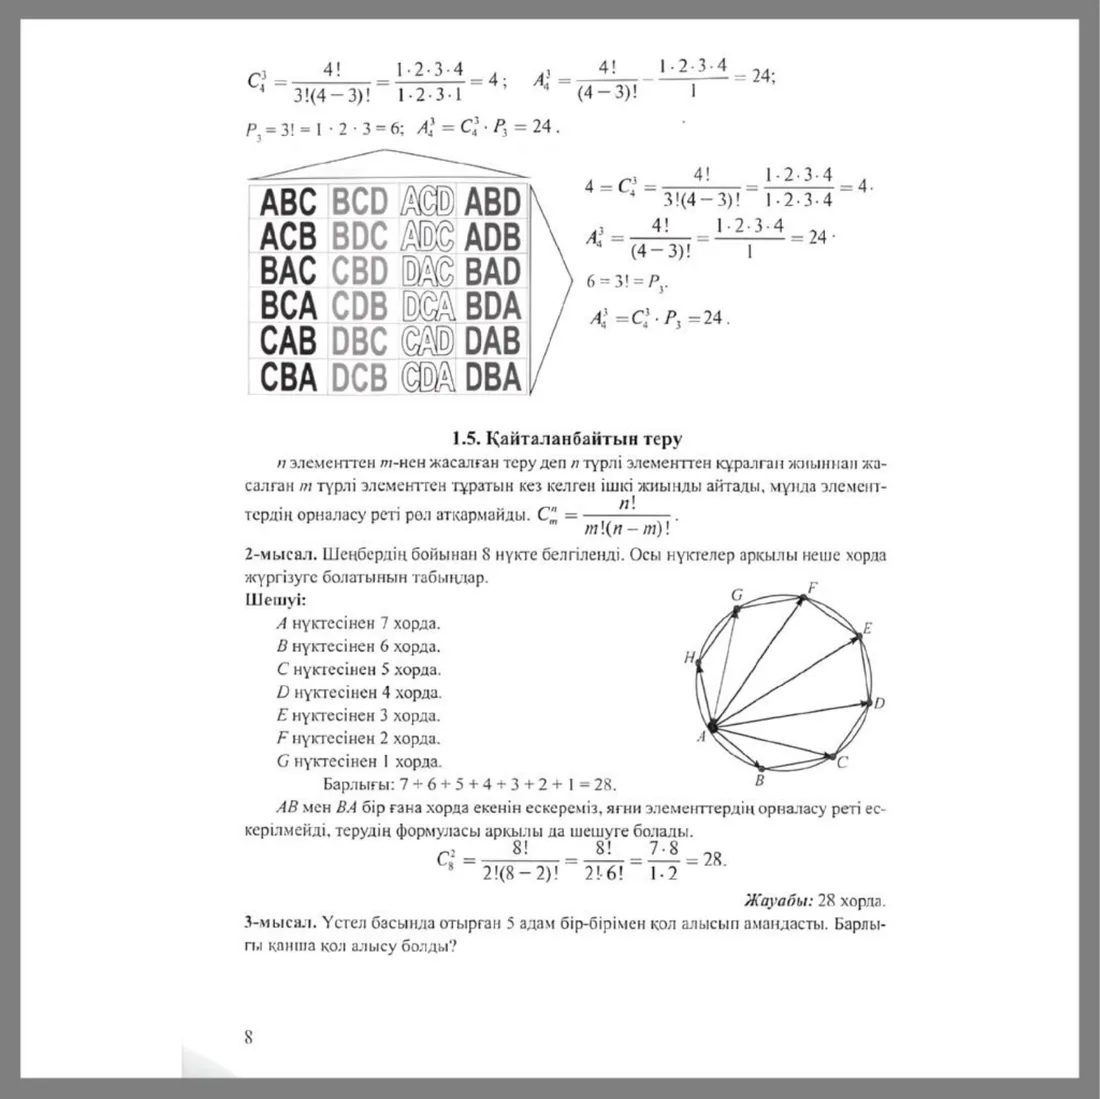
Такие страницы были сущим кошмаром: на одной странице сразу формула, таблица, иллюстрация и казахский текст. Итоговый конвейер обрабатывал их комбинированно. Иллюстрации детектились и сохранялись отдельными картинками, формулы переводились в нотацию LaTeX, а таблицы распознавались отдельным процессом, который сначала считывал структуру, а затем сканировал каждую ячейку.
Результат
Тысячи структурированных страниц контента опубликованы для трёх локалей без пропорционального роста штата. Органический поисковый трафик начал накапливаться с первых недель после запуска по мере индексации страниц. Архитектура пайплайна позволяет добавлять новые классы, предметы или учебники, просто обновив входные данные учебной программы - без изменений кода.
По теме
Проекты
Traffic Connect - оркестрация ИИ-контента для сайтов на WordPress
До: генерацию статей с помощью ИИ нужно было вести на множестве сайтов на WordPress, и управлять ею из одного места было нельзя. После: одна админ-панель ставит задачи в очередь для каждого сайта, а сайт сам забирает свои задачи через плагин. Систему я собрал с нуля примерно за месяц.
PREZA - сайты школьных презентаций с более чем 80 000 сгенерированных PDF
До: сайтам школьных презентаций нужны были десятки тысяч готовых файлов, сделать которые вручную было невозможно. После: грабберы, парсеры и автоматическая многопоточная генерация дали больше 80 000 PDF, которые хранятся в холодном S3 Selectel и опубликованы на preza.kz и preza.top.
AtomPk Grabber - выгрузка списка товаров в CSV по требованию
До: партнёру нужно было раз за разом вручную собирать список товаров с сайта в CSV. После: исполняемый файл, который запускается двойным кликом, сам обходит каталог и пишет CSV - без установки Python и без настройки.
Открыт для работы по контракту
Я доступен для работы по контракту. Если у вас есть интересная идея проекта, запишитесь на звонок через Calendly.
Записаться на 30-минутный звонок