Проект с ИИ-агентом2 мин чтения
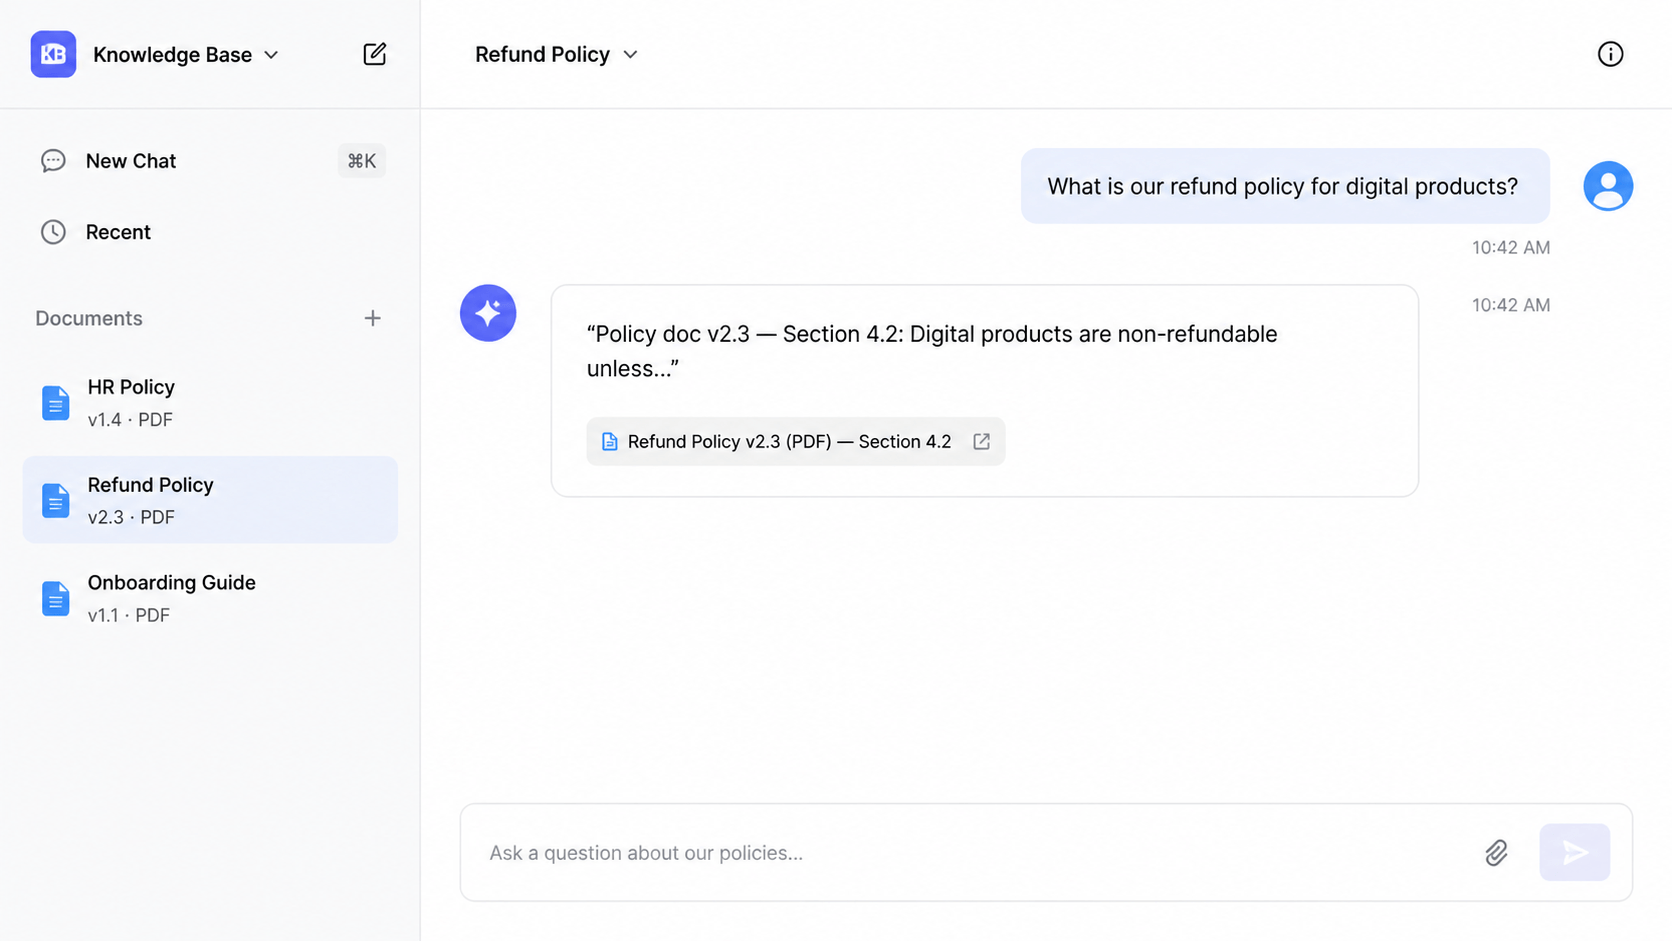
ИИ-агент базы знаний
Технологии
Услуги
- →Пайплайн загрузки документов (Google Drive, Notion, PDF)
- →База знаний на RAG с гибридным векторным и ключевым поиском
- →Интеграция Slack-бота с ответами в тредах
- →Веб-интерфейс с историей переписки и ссылками на источники
- →Режим составления готовых для поддержки ответов
- →Инкрементальное обновление индекса при изменении документов
Результаты
- ✓ИИ-ассистент, индексирующий существующие документы - без миграции
- ✓Q&A на естественном языке со ссылками на источники
- ✓Slack-бот для команды - ответы в тредах
- ✓Генератор черновиков ответов клиентам для агентов поддержки
- ✓Обратная связь для непрерывного повышения качества
- ✓Гибридный поиск: плотные эмбеддинги + ключевой BM25
Задача
У растущей команды за три года накопилась документация компании, разбросанная по папкам Google Drive, вики в Notion и почтовым архивам. Корпоративные знания были заперты в PDF и документах, которые никто не мог быстро найти. Новые сотрудники первые недели задавали старшим коллегам вопросы, ответы на которые формально уже где-то были задокументированы. Агенты поддержки раз за разом заново писали один и тот же ответ на один и тот же вопрос клиента, потому что канонический ответ нигде не всплывал.
Рассмотренные варианты
- Улучшенная структура папок и поиск - пробовали раньше. Полнотекстовый поиск помогал с точными ключевыми словами, но не справлялся с концептуальными вопросами вроде «какова наша политика по частичному возврату за цифровые товары».
- Отдельный вики-инструмент (Confluence, Guru) - требовал ручного переноса существующих документов и постоянного ведения. В прошлой попытке использование сошло на нет через три месяца.
- ИИ-агент на RAG поверх существующих документов - выбранный вариант. Работает с документами там, где они уже лежат, не требует миграции и отвечает на вопросы естественным языком, а не выдаёт ссылку на страницу, которую пользователю ещё предстоит прочитать.
Решение
Агент индексирует всю имеющуюся документацию - Google Drive, страницы Notion, загруженные PDF - в векторную базу данных. Slack-бот и веб-интерфейс позволяют сотрудникам задавать вопросы простым языком. Агент извлекает релевантные фрагменты документов, синтезирует ответ и ссылается на исходный документ. У агентов поддержки есть кнопка «черновик ответа клиенту», которая формирует готовый для поддержки ответ из той же базы знаний.
Реализация
Пайплайн загрузки документов синхронизирует Google Drive и Notion через их API, разбивает документы на перекрывающиеся сегменты и встраивает их с помощью OpenAI Embeddings в индекс Pinecone. Индекс обновляется инкрементально при изменении документов. Слой извлечения использует гибридный поиск - плотную векторную близость плюс ключевой BM25 - для повышения полноты по именованным сущностям и артикулам товаров.
Slack-бот построен на фреймворке Bolt и отвечает в тредах, чтобы не засорять каналы. Веб-интерфейс добавляет историю переписки и кнопку обратной связи (лайк/дизлайк), которая логирует некачественные ответы для донастройки промптов. Режим «черновик ответа клиенту» применяет отдельный промпт, который переоформляет ответ для внешней аудитории, убирает внутренний жаргон и добавляет вежливые приветствие и завершение.
Результат
Время онбординга новых сотрудников на этапе документации сократилось с 2 недель до 3 дней. Команда поддержки снизила среднее время обработки вопросов по регламентам на 65%. Старшие сотрудники отметили, что их реже отвлекают вопросами, которые «и так где-то задокументированы». Система отвечала на 80% запросов без единой эскалации к человеку.
По теме
Проекты
Traffic Connect - оркестрация ИИ-контента для сайтов на WordPress
До: генерацию статей с помощью ИИ нужно было вести на множестве сайтов на WordPress, и управлять ею из одного места было нельзя. После: одна админ-панель ставит задачи в очередь для каждого сайта, а сайт сам забирает свои задачи через плагин. Систему я собрал с нуля примерно за месяц.
PREZA - сайты школьных презентаций с более чем 80 000 сгенерированных PDF
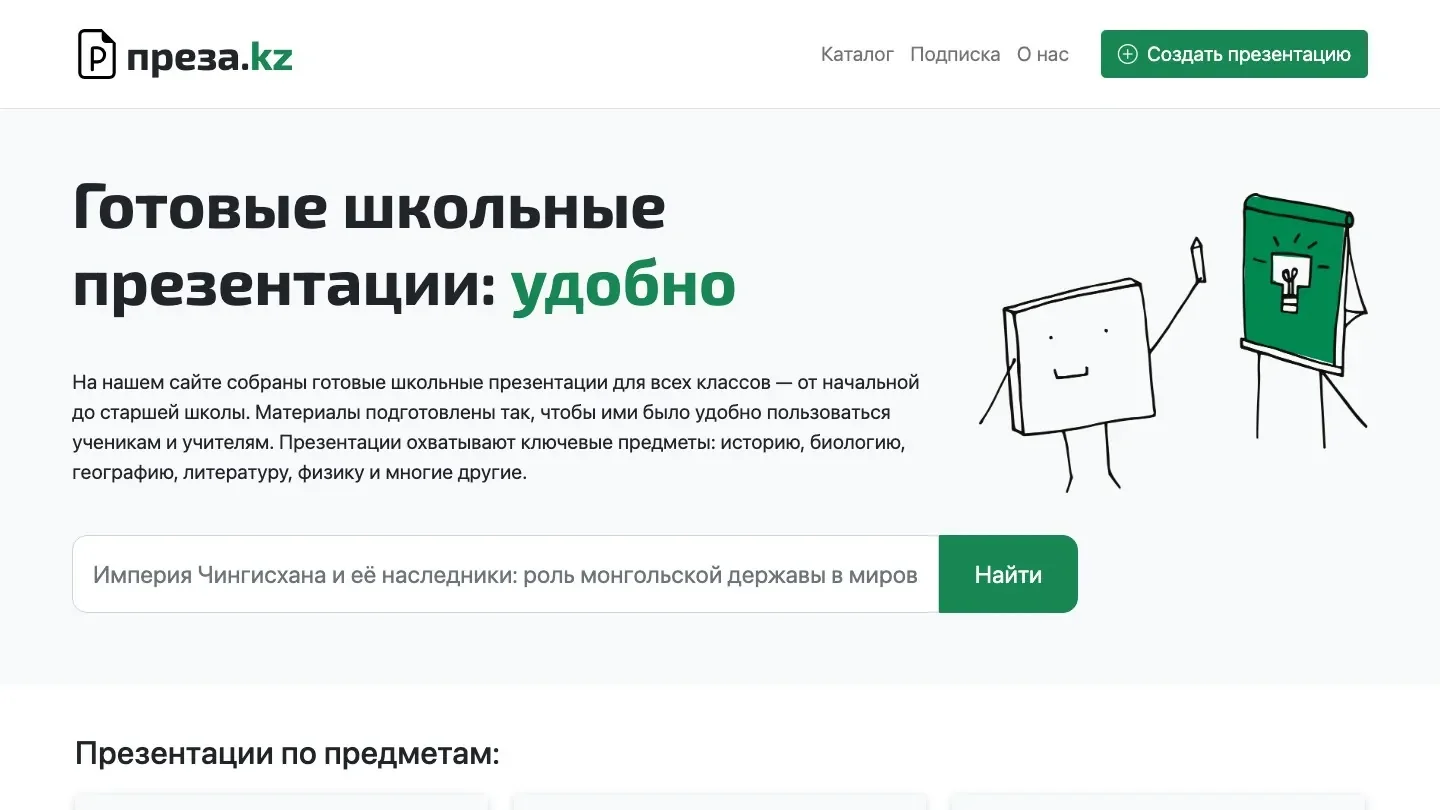
До: сайтам школьных презентаций нужны были десятки тысяч готовых файлов, сделать которые вручную было невозможно. После: грабберы, парсеры и автоматическая многопоточная генерация дали больше 80 000 PDF, которые хранятся в холодном S3 Selectel и опубликованы на preza.kz и preza.top.
AtomPk Grabber - выгрузка списка товаров в CSV по требованию
До: партнёру нужно было раз за разом вручную собирать список товаров с сайта в CSV. После: исполняемый файл, который запускается двойным кликом, сам обходит каталог и пишет CSV - без установки Python и без настройки.
Открыт для работы по контракту
Я доступен для работы по контракту. Если у вас есть интересная идея проекта, запишитесь на звонок через Calendly.
Записаться на 30-минутный звонок